企業がAIを導入する際、最初の壁はモデルではなく、Excelに散らばったデータである
企業のAI導入について話すとき、多くの人はまずどのモデルを選ぶかを尋ねがちです。しかしここ数年、企業とやり取りする中でよく見かける最初の実際的な問題は、「会社のデータは一体どこにあるのか?それが何を意味するのか誰が知っているのか?」ということです。
デプロイ方式、モデルの選択、導入上の提案
企業によってデータの保存とモデルサービスへの要件は異なります。パブリッククラウド環境のマネージドサービスを使用できる企業もあれば、企業のプライベートクラウド、VPC、社内のデータセンターに置かなければならない企業もあります。AotterClam AI の公式資料には、企業のプライベートクラウドやオンプレミスデプロイのオプションが記載されており、ロールと権限の設定、操作記録が可能であること、またローカル推論または外部 AI モデルへの接続など異なる方式が提供されていることが説明されています。5
「データが国境を越えない」あるいは「データが会社を出ない」という話をするとき、私たちはこの一文を具体的なデータ経路に分解して確認することをお勧めします。データベース自体はどこに置かれているのか?バックアップとログはどの地域に保存されているのか?モデルの推論はどこで実行されるのか?ユーザーが質問をするとき、システムはどの列、要約、またはクエリ結果をモデルに送信するのか?サポート担当者はデータにアクセスできるのか?サービスプロバイダーのサブプロセッサーには何があるのか?「私たちはオンプレミスに構築している」と答えるだけでは不十分です。なぜなら、一つの企業システムには通常、バックアップ、監視、アップデート、外部モデル、運用保守のチャンネルも含まれているからです。
同様に、BYOK(Bring Your Own Key)とは通常、企業が自前のモデルサービスの API キーを用意することを指します。BYOAI はよく企業が自社の AI モデルやサービスを選択または持ち込むことを表すために使われます。これらはモデルと費用管理の採用方式であり、データが自動的に保護されることを意味するわけではなく、個人版の ChatGPT や Claude のサブスクリプションに必ず企業向け API の権限が含まれているという意味でもありません。実際に接続できるかどうか、どう課金されるか、データがモデルの学習に使われるかどうか、ログがどれくらい保存されるかは、モデルプロバイダーのサービス条項と企業のデプロイ設定に応じてすべて確認すべきです。
MCP は AI ツールが標準化された方式でデータサービスに接続できるようにしますが、MCP 自体はプライバシー保護プロトコルではなく、データがどこまで公開されるべきかを自動的に決定するものでもありません。企業は照会可能なデータ範囲、列のマスキング、ロールベースの権限、クエリの記録、外部モデルの使用ポリシーを定義する必要があります。もしユーザーが商品在庫と売上トレンドだけを必要とするなら、システムは同じデータベースに顧客の電話番号や住所があるからといって、それらの列を一緒にモデルに露出させるべきではありません。
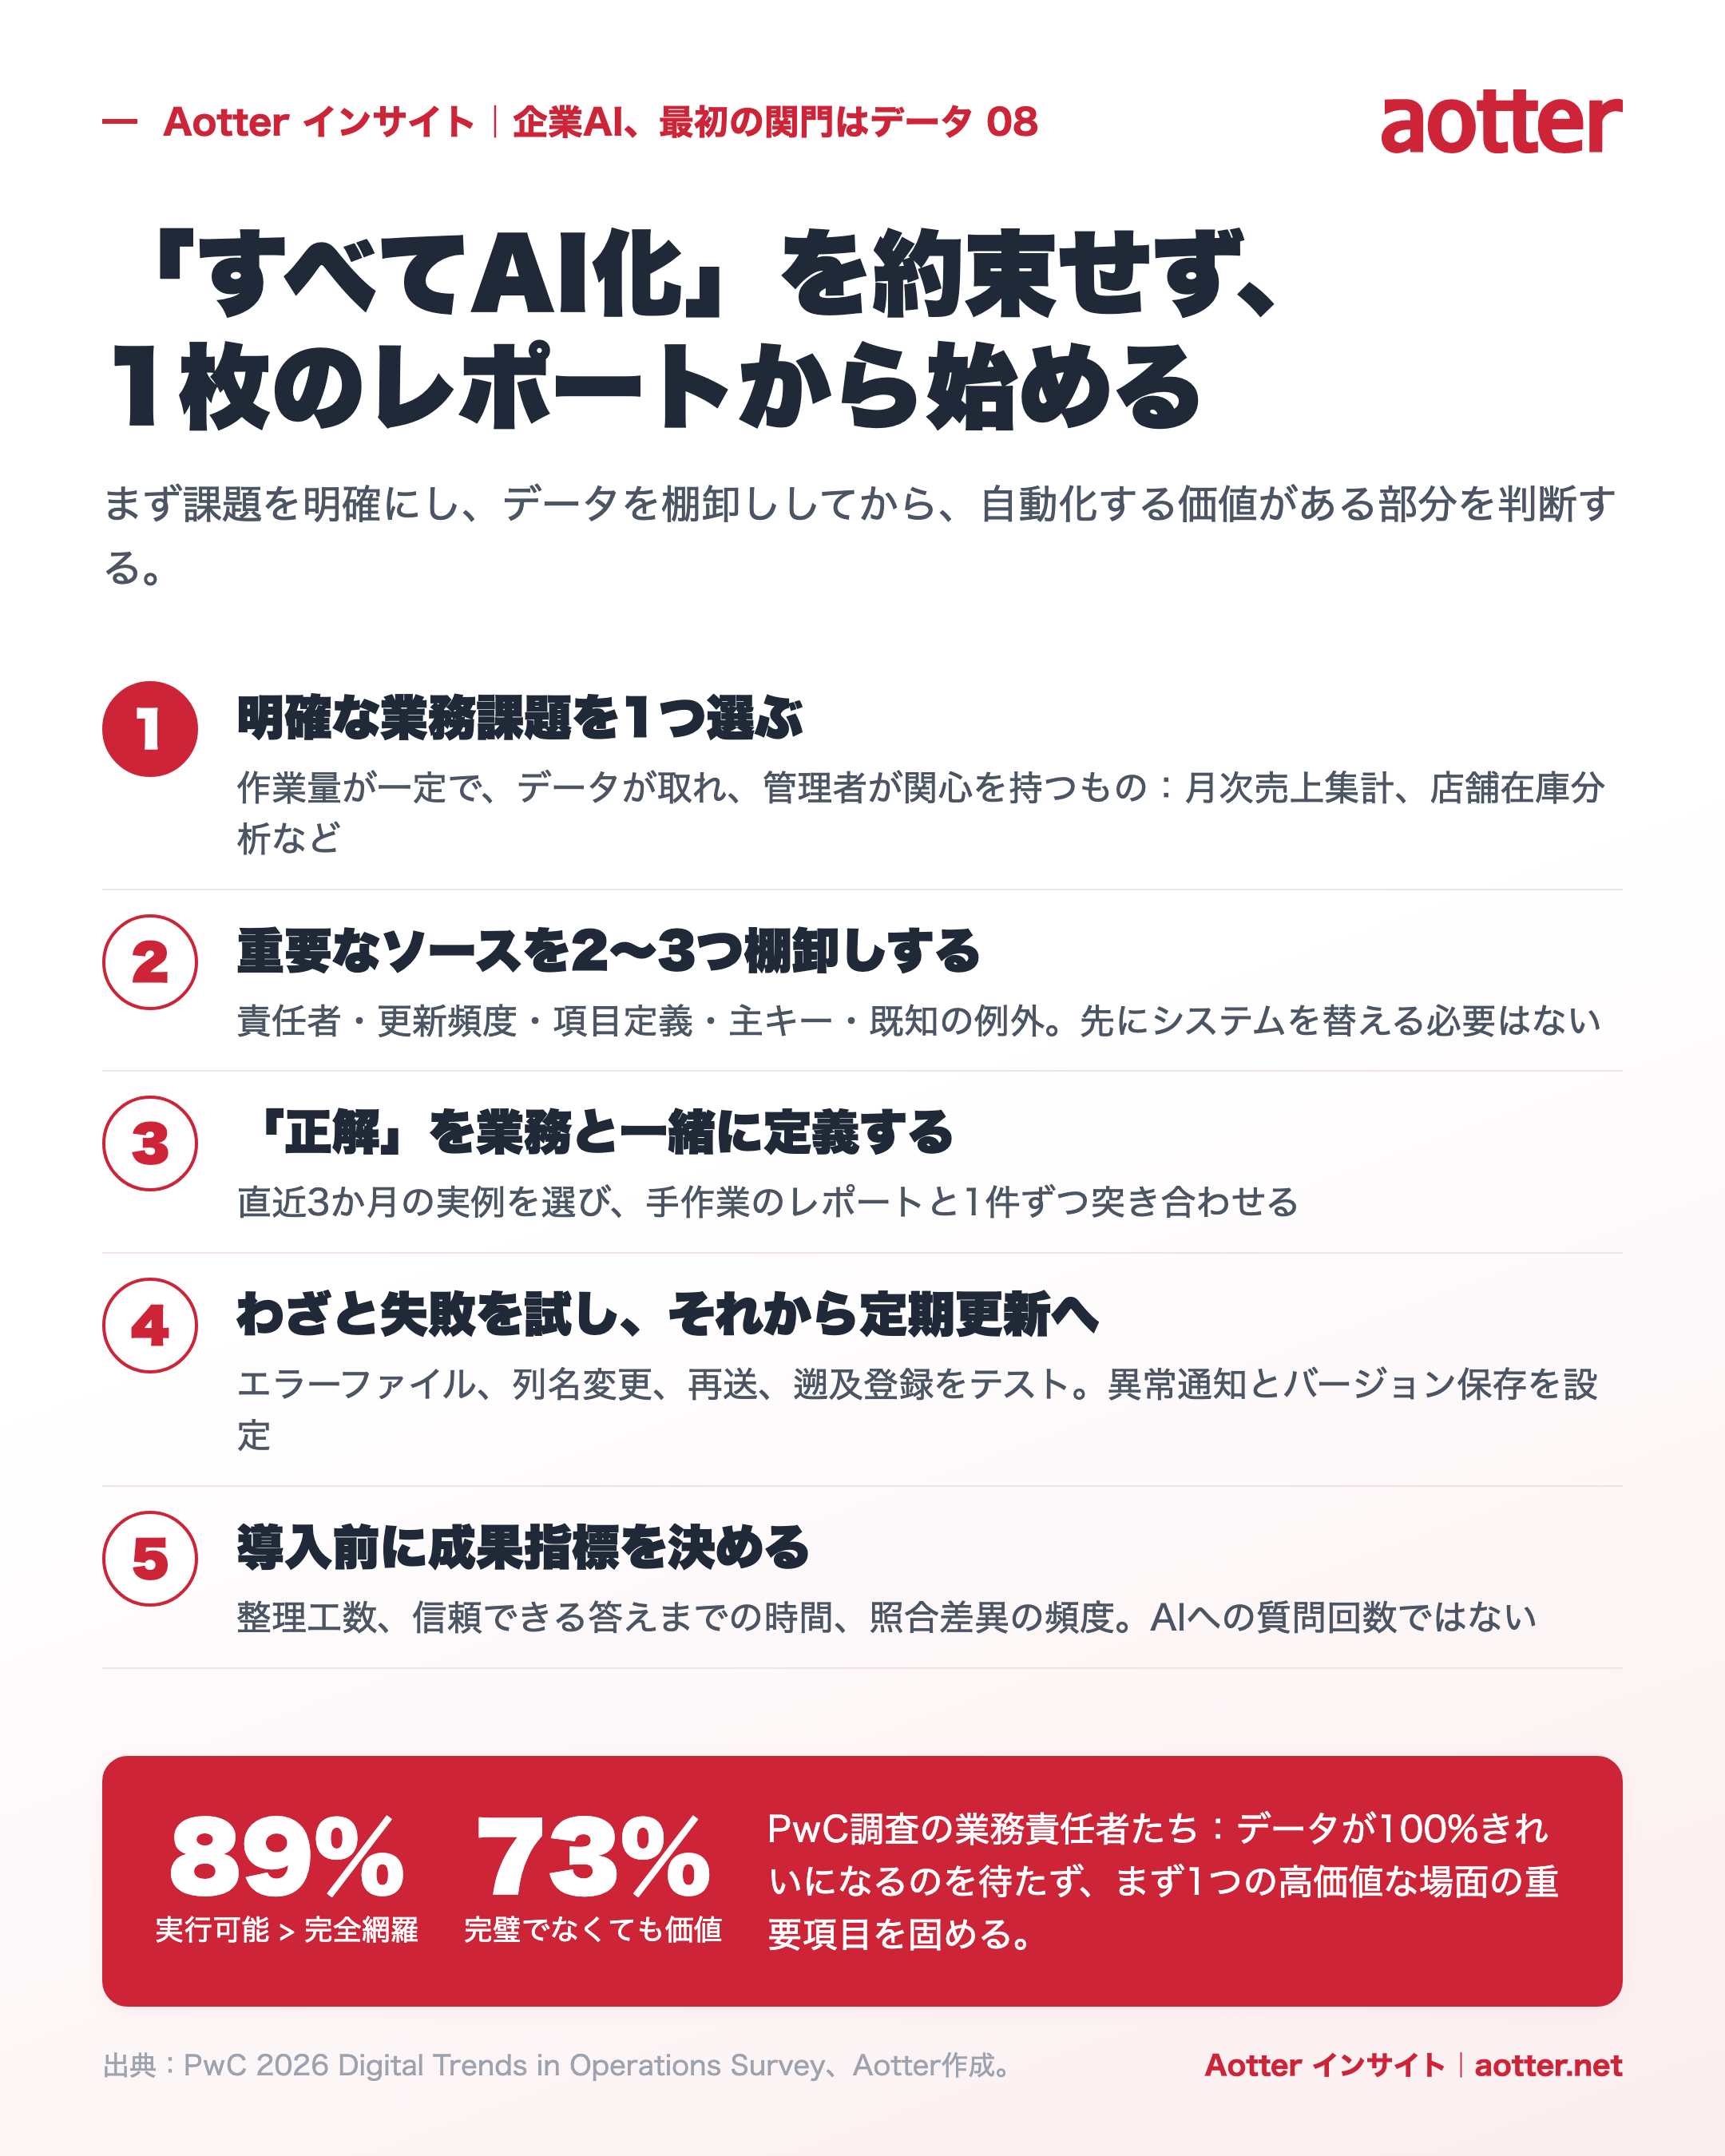
導入にあたっては、私たちは明確なビジネス上の質問から始めることをお勧めし、最初から「すべてのデータを AI 化する」と約束しないことをお勧めします。企業はまず、固定の作業量があり、データソースが取得可能で、管理者も気にかけている場面を一つ選ぶことができます。例えば毎月の売上集計、店舗ごとの在庫分析、サプライヤーの納期追跡、カスタマーサービスの問い合わせ分類などです。目標となる質問文を明確にすれば、どのデータを接続すべきか、どの列が重要か、検証方法は何かが分かります。
次に、最も重要な二〜三件のソース文書またはシステム出力の棚卸しを行います。各データの所有者、更新頻度、列の定義、保存規範、主キー、既知の例外を見つけ出す必要があります。このステップは、すべてのシステムを先に交換する必要はありません。まず既存のデータがスケジュールに従ってエクスポートできるかどうか、システムがデータを読み取る権限があるかどうか、データが企業指定の環境内で処理できるかどうかを確認します。もしデータが現状手動で送信するしかないなら、まず送信方法、ファイルの命名規則、受け取りルールを定めて、プロセスを安定させてから拡張を議論します。
さらに、ビジネス側と一緒に「正しい答え」の判断基準を定義します。目標が毎月の純売上であれば、少なくともキャンセル注文、返金、値引き、税額、出荷時間をどう計算するかを説明すべきです。目標が在庫回転であれば、期首在庫、期末在庫、輸送中の商品、欠品日数をどう処理するかを約束すべきです。直近三ヶ月の実際の事例を選び出し、既存の手作業レポートと一件ずつ比較して、差異がどのルールに起因するかを確認すべきであり、一枚のきれいなサンプルファイルだけでテストすべきではありません。
その後ようやく検証と拡張を手配します。まず一般的なファイルをテストし、意図的にエラーファイル、列名変更、空値の急増、再送信による重複ファイル、履歴データの補完、新しいコードの追加などのシナリオもテストすべきです。合格後にスケジュール更新を開始し、データ異常の通知、バージョン保存、手動での例外処理フローを設定します。二番目のソースが追加されたとき、企業はデータの関連が安定しているかどうかを観察し、三番目の部門を含めるかどうかを決定できます。
成果の測定も開始前から設定しておくべきです。同僚が毎月データ整理に費やす工数、質問から信頼できる答えを得るまでの時間、手動での作業のやり直しや照合の差異の頻度、管理者が意思決定前にレポートを待つ日数、または特定の在庫やカスタマーサービス指標の変化を記録できます。もし AI 問答の使用回数だけを計算するなら、「みんなが試用した」ということを「業務プロセスが改善された」ことと誤認しやすくなります。企業が導入前後の違いを明確に説明できるようになったとき、次の予算をデータ品質、プロセス自動化、あるいはより複雑なモデル応用のどこに投じるべきかが分かります。
PwC の 2026 年調査のもう一つの観察結果は、導入戦略に組み込む価値があります。回答した運営責任者のうち、89% が行動可能なデータの方が完全なデータを追求するよりも重要だと考えており、73% がデータが完璧でなくても価値を生み出せると考えています。これはデータのエラーを無視してよいという意味ではなく、企業がすべてのデータが「百パーセントクリーン」になるまで待つ必要はないということです。より現実的な方法は、まず一つの高価値な場面に対して重要な列の品質を向上させつつ、残りのデータも継続的に改善し、明確な検証とリスクの等級分けで最低限のラインを守ることです。2
 AIアドバイザリー · Powered by MCP
もっと深く知りたい?「AOTTERSMAN」をあなたのAIアドバイザーに
この記事の詳細な推論と実践チェックリストは、AOTTERSMANナレッジベースに収録されています。MCPを導入すれば、お使いのAIアシスタント(Claude / Cursor / Gemini…)がAOTTERSMANの思考フレームワークを直接活用——常時オンラインのAIアドバイザーがもう一人増えるイメージです。
自社専用のAI頭脳を育てる
社内の知識とデータを蓄積し、使うほどにAIがビジネスの文脈を理解していきます。