企業がAIを導入する際、最初の壁はモデルではなく、Excelに散らばったデータである
企業のAI導入について話すとき、多くの人はまずどのモデルを選ぶかを尋ねがちです。しかしここ数年、企業とやり取りする中でよく見かける最初の実際的な問題は、「会社のデータは一体どこにあるのか?それが何を意味するのか誰が知っているのか?」ということです。
データウェアハウスから上へ:AI が日常業務に入り込むために
データを整理することは、企業の変革が終わったことを意味するわけではありません。それはむしろ地盤を固めることに近く、後続のデータ分析、BI ダッシュボード、自然言語の問答、AI エージェントが従うことのできるデータソースを用意することです。データの基盤に権限、バージョン、定義がなければ、上層の AI はおそらくより速く、一見完全に見えるが実際には口径が一致しない答えを生み出すだけになるでしょう。
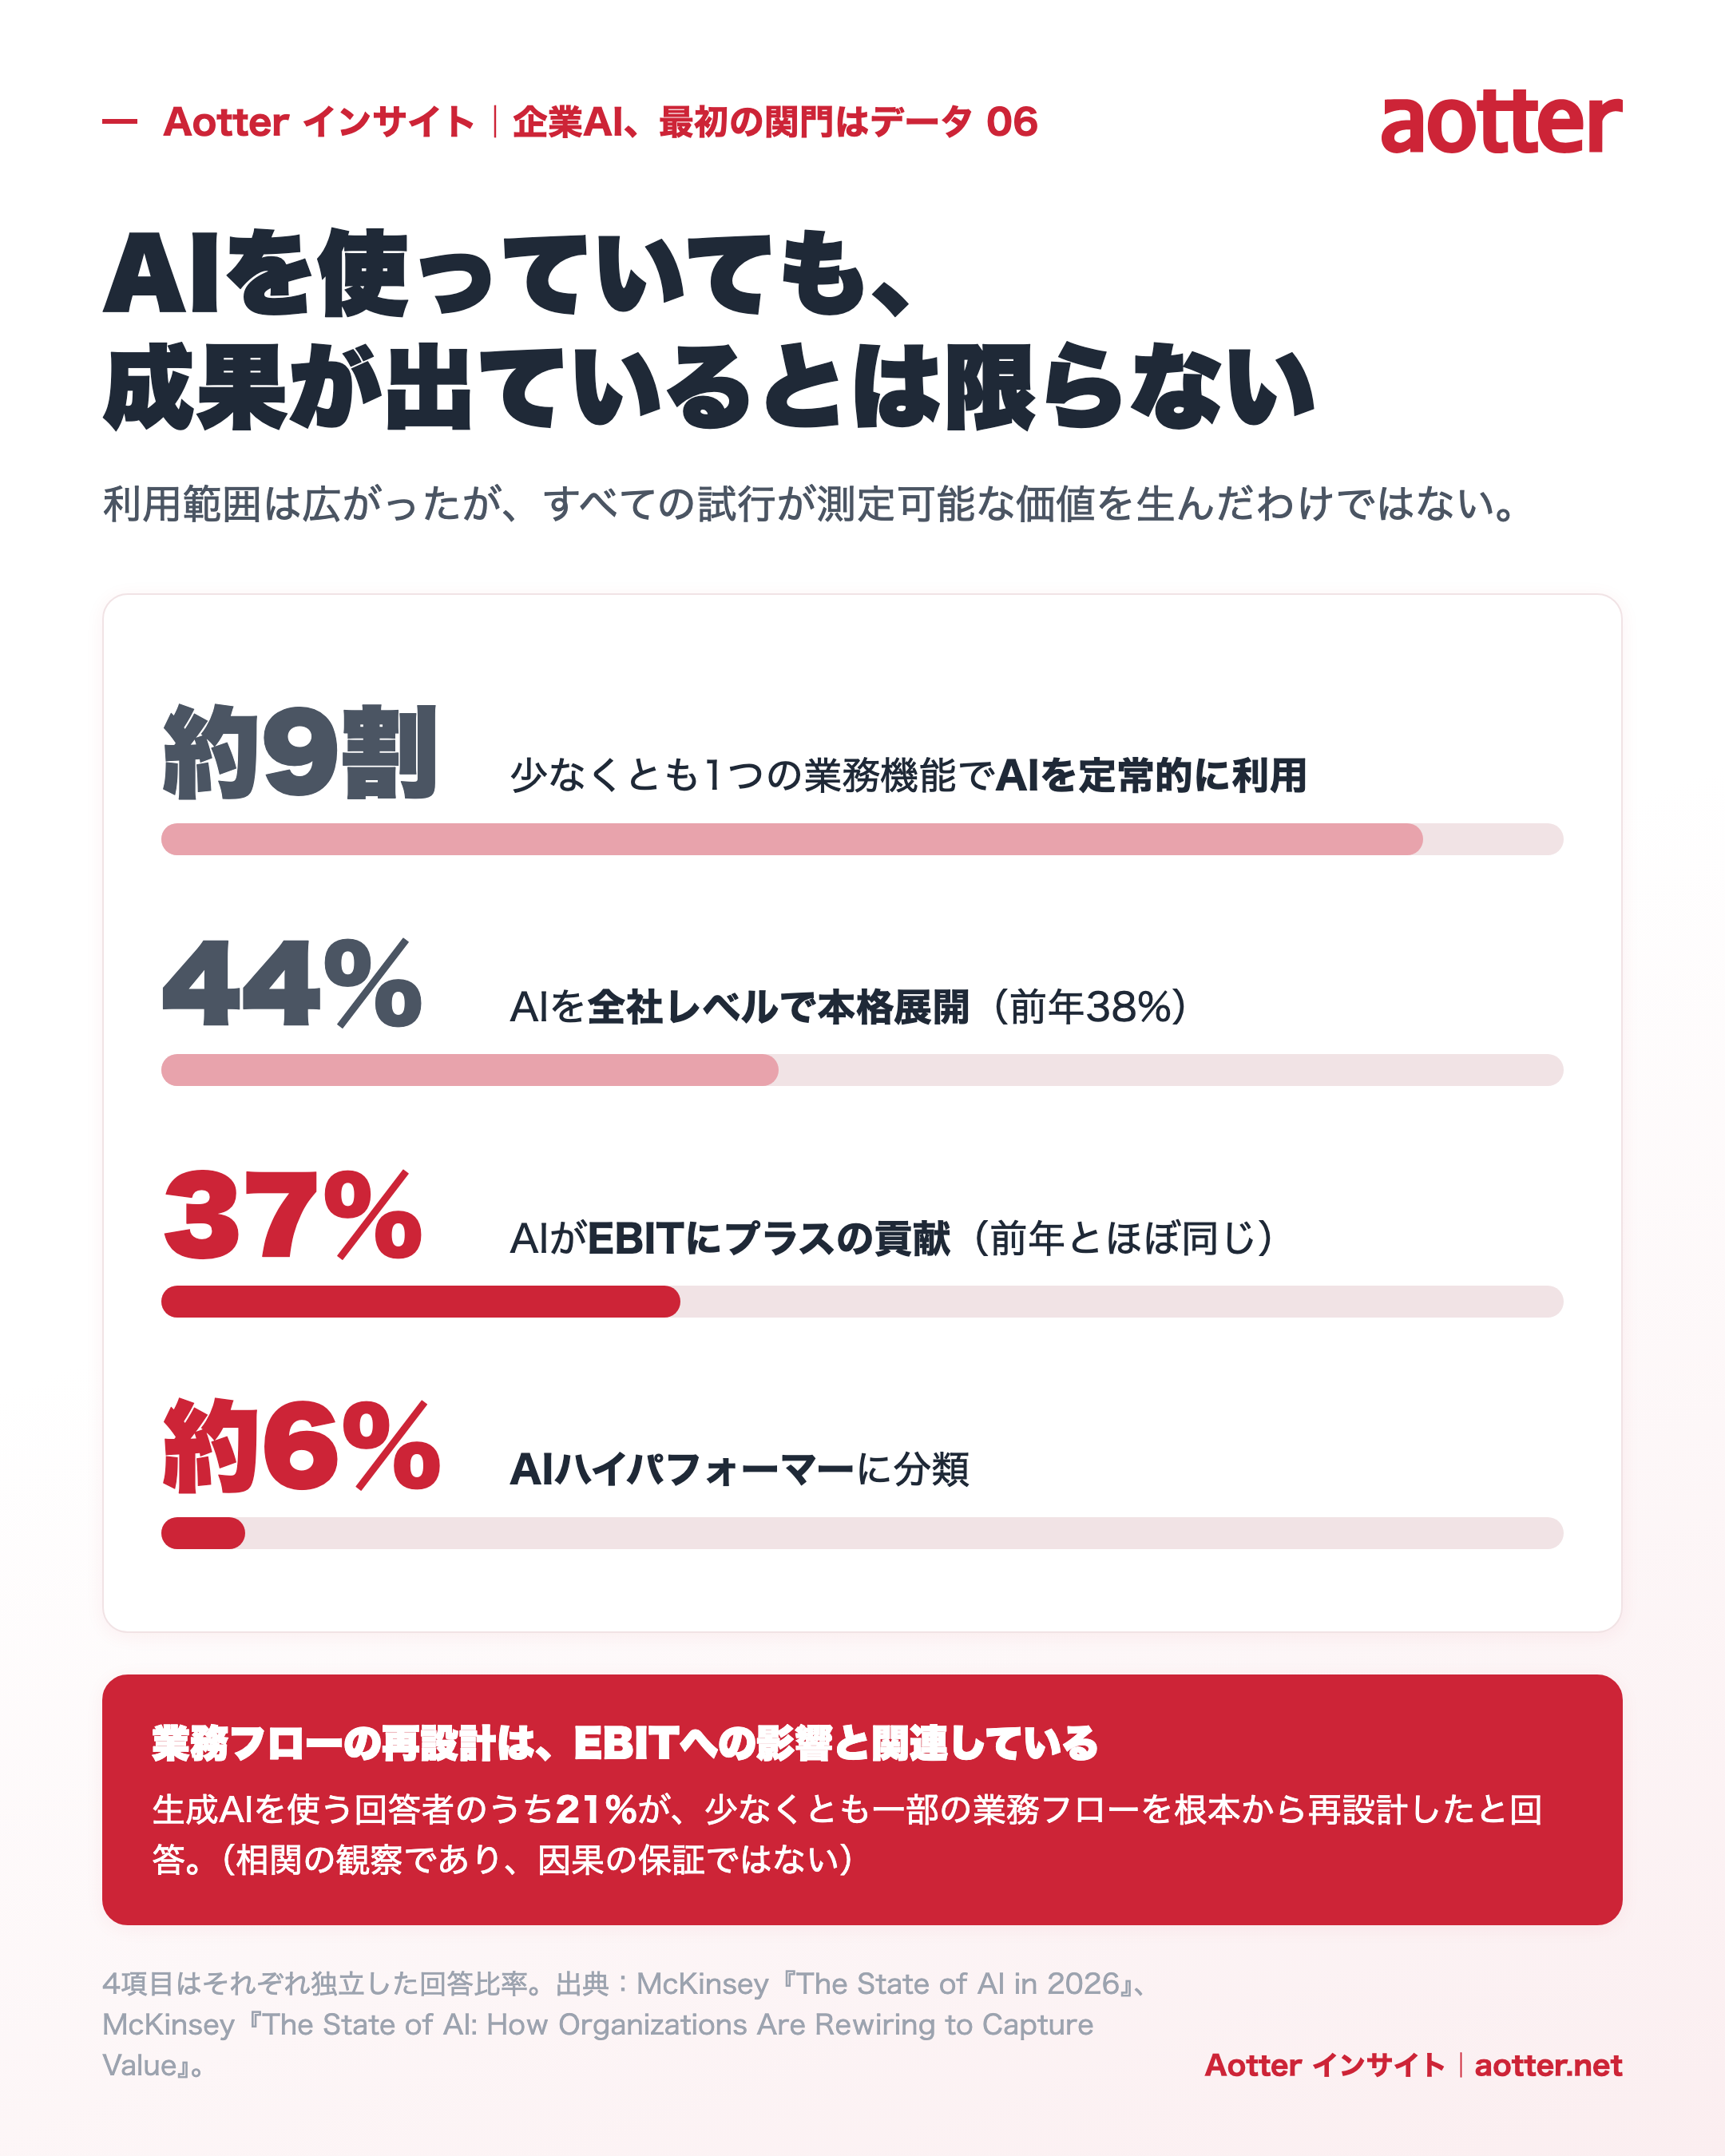
McKinsey の 2026 年《State of AI》調査によると、回答者の約 9 割が所属組織が少なくとも一つのビジネス機能で定期的に AI を使用していると答え、44% が AI が既に企業レベルで拡大展開されていると答えており、これは前年の 38% を上回っています。しかし「使っている」ことは「既に全面的に財務上のリターンを得ている」ことを意味しません。37% の回答者が AI が企業の EBIT にプラスの貢献をしていると答えており、この比率は前年とほぼ同程度です。約 6% が AI ハイパフォーマンス組織に分類されています。これらの数字は企業が立ち止まって考えるべきものです。AI の使用範囲は拡大していますが、すべてのパイロットプロジェクトが既に測定可能な運営価値を形成しているわけではないことを示しています。7
McKinsey の別の分析では、ワークフローの再設計が、回答組織が生成系 AI で EBIT への影響を見られるかどうかに関連する要因の一つであることを指摘しています。生成系 AI を使用している回答者のうち、21% が所属組織が少なくとも一部のワークフローを根本的に再設計したと答えています。これは調査における相関関係の観察であり、プロセスを変えさえすれば必ず利益が向上するという意味ではなく、ましてすべての企業に対する因果関係の保証でもありません。しかしこれは、企業が AI を単に旧来のプロセスの横に付け加えるだけであってはならず、むしろ問うべきであることを示しています。どの意思決定、引き継ぎ、待機、あるいは繰り返しの整理が再設計できるのか、と。8
多くの企業にとって、データが倉庫に入った後、最初に実現可能な変化は必ずしも完全自動の AI エージェントではなく、答えを得るまでの時間を短縮することかもしれません。以前は毎月同僚が数時間かけて ERP、倉庫、売上レポートを統合していましたが、今ではまず固定のフローを自動化し、管理者が自然言語で在庫回転、チャネル別売上、品目の変化を尋ねられるようにできます。次のステップでは、これらの照会結果を補充発注、カスタマーサービス、予算プロセスに接続し、データを単にダッシュボードに表示されるだけのものではなく、実際の行動の根拠にできます。
《デジタルタイムズ(數位時代)》が 2026 年に Aotter と AotterClam AI について報じた記事では、企業が毎月業績、会計、在庫データを整理するシナリオでデータエンジニアリングの問題を説明し、また従来型企業が ERP の再構築を検討した後、代わりに旧システムが出力するレポートを見直し、別途データウェアハウスを構築するという方法を取ったことも報じています。これは個別企業の事例であり、すべての企業が ERP を交換する必要がないと直接推論すべきではありません。しかし、これはよく見落とされる選択肢を指摘しています。もし旧システムが依然として中核的な運営を支えているなら、企業はまず部門横断的なデータ利用方法を改善し、それから全面的な刷新が必要かどうかを評価することができるのです。9
データガバナンスとはデータを鍵をかけて閉じ込めることではなく、データを正しい範囲内で使用させることである
データウェアハウスが照会可能かどうかは、ガバナンスの一部に過ぎません。本当のガバナンスには、データのソースと使用目的、データ品質、列の定義、保存期限、機密度、権限、監査記録、異常処理、責任の所在も含まれます。データが全く使用できなければ価値を生み出せませんが、もし誰もがどんなモデルも制限なくすべてのデータを見られるとしたら、それも成熟したガバナンスではありません。
台湾の《人工知能基本法》は 2025 年 12 月 23 日に立法院で三読を通過しました。数位発展部がまとめた七大原則には、持続可能な発展と福祉、人間の自律性、プライバシー保護とデータガバナンス、情報セキュリティと安全、透明性と説明可能性、公平性と非差別、そして説明責任が含まれます。これらの原則はデータガバナンスを AI 発展の基本的な枠組みの中に組み込んでおり、企業に対して、AI の導入は単にモデルの能力だけに関わるのではなく、データをどう取得するか、誰が責任を負うか、どう開示するか、問題が発生した場合どう追跡するかにも関わることを思い出させてくれます。12
EU の AI Act はリスク等級分けの方式を採用しており、すべての AI 使用状況に完全に同じ要件を適用するわけではありません。特定の高リスクシステムについては、関連ルールがデータセットの品質、リスク管理、活動記録、文書、人的監督、堅牢性とセキュリティなどの側面をカバーしています。EU 公式のスケジュールもその後調整されており、一部の高リスク用途のルールは 2027 年から適用されることになっています。したがって、企業はサービス提供市場、実際の用途、データの種類に応じて適用される義務を確認すべきであり、「EU AI 法」を、すべての社内 AI ツールが同じチェックリストを履行しなければならないかのように単純化すべきではありません。13
私たちはデータガバナンスを計画する際、問題を日常の操作に引き戻して考えます。売上データは誰が見られるのか?カスタマーサービスの記録には個人情報が含まれているか?管理者が照会結果をダウンロードできるか?外部 AI モデルを使用する際、どの列が送信されるのか?元ファイルはどれくらい保存するのか?もしある同僚が退職したり役割が変わったりした場合、権限はいつ取り消されるのか?データが修正された後、旧レポートとモデルの答えはどう更新されるのか?これらの問題は「モデルがどれだけ賢いか」ほど目を引くものではありませんが、企業が安心して AI をワークフローに組み込めるかどうかを決定します。
2025 年人工知能科技基金会によるデータガバナンスについての専門家インタビューでも、データガバナンスは戦略と応用シナリオから出発する必要があり、IT 部門だけに列の定義やツールの設置を任せるべきではないと指摘されています。ビジネス責任者は、データがどの意思決定を支えるべきかを最もよく理解しており、データチームはその定義を標準、品質チェック、データリネージに変換できます。両者は一緒に責任を負う必要があります。インタビューで提示されたガバナンス能力には、データが発見可能であること、認可されたアクセスが可能であること、デバッグ可能であること、実際のプロセスにデプロイ可能であることが含まれており、ちょうど企業がデータを「保存できる」状態から「よく使える」状態に推進する必要性に呼応しています。6
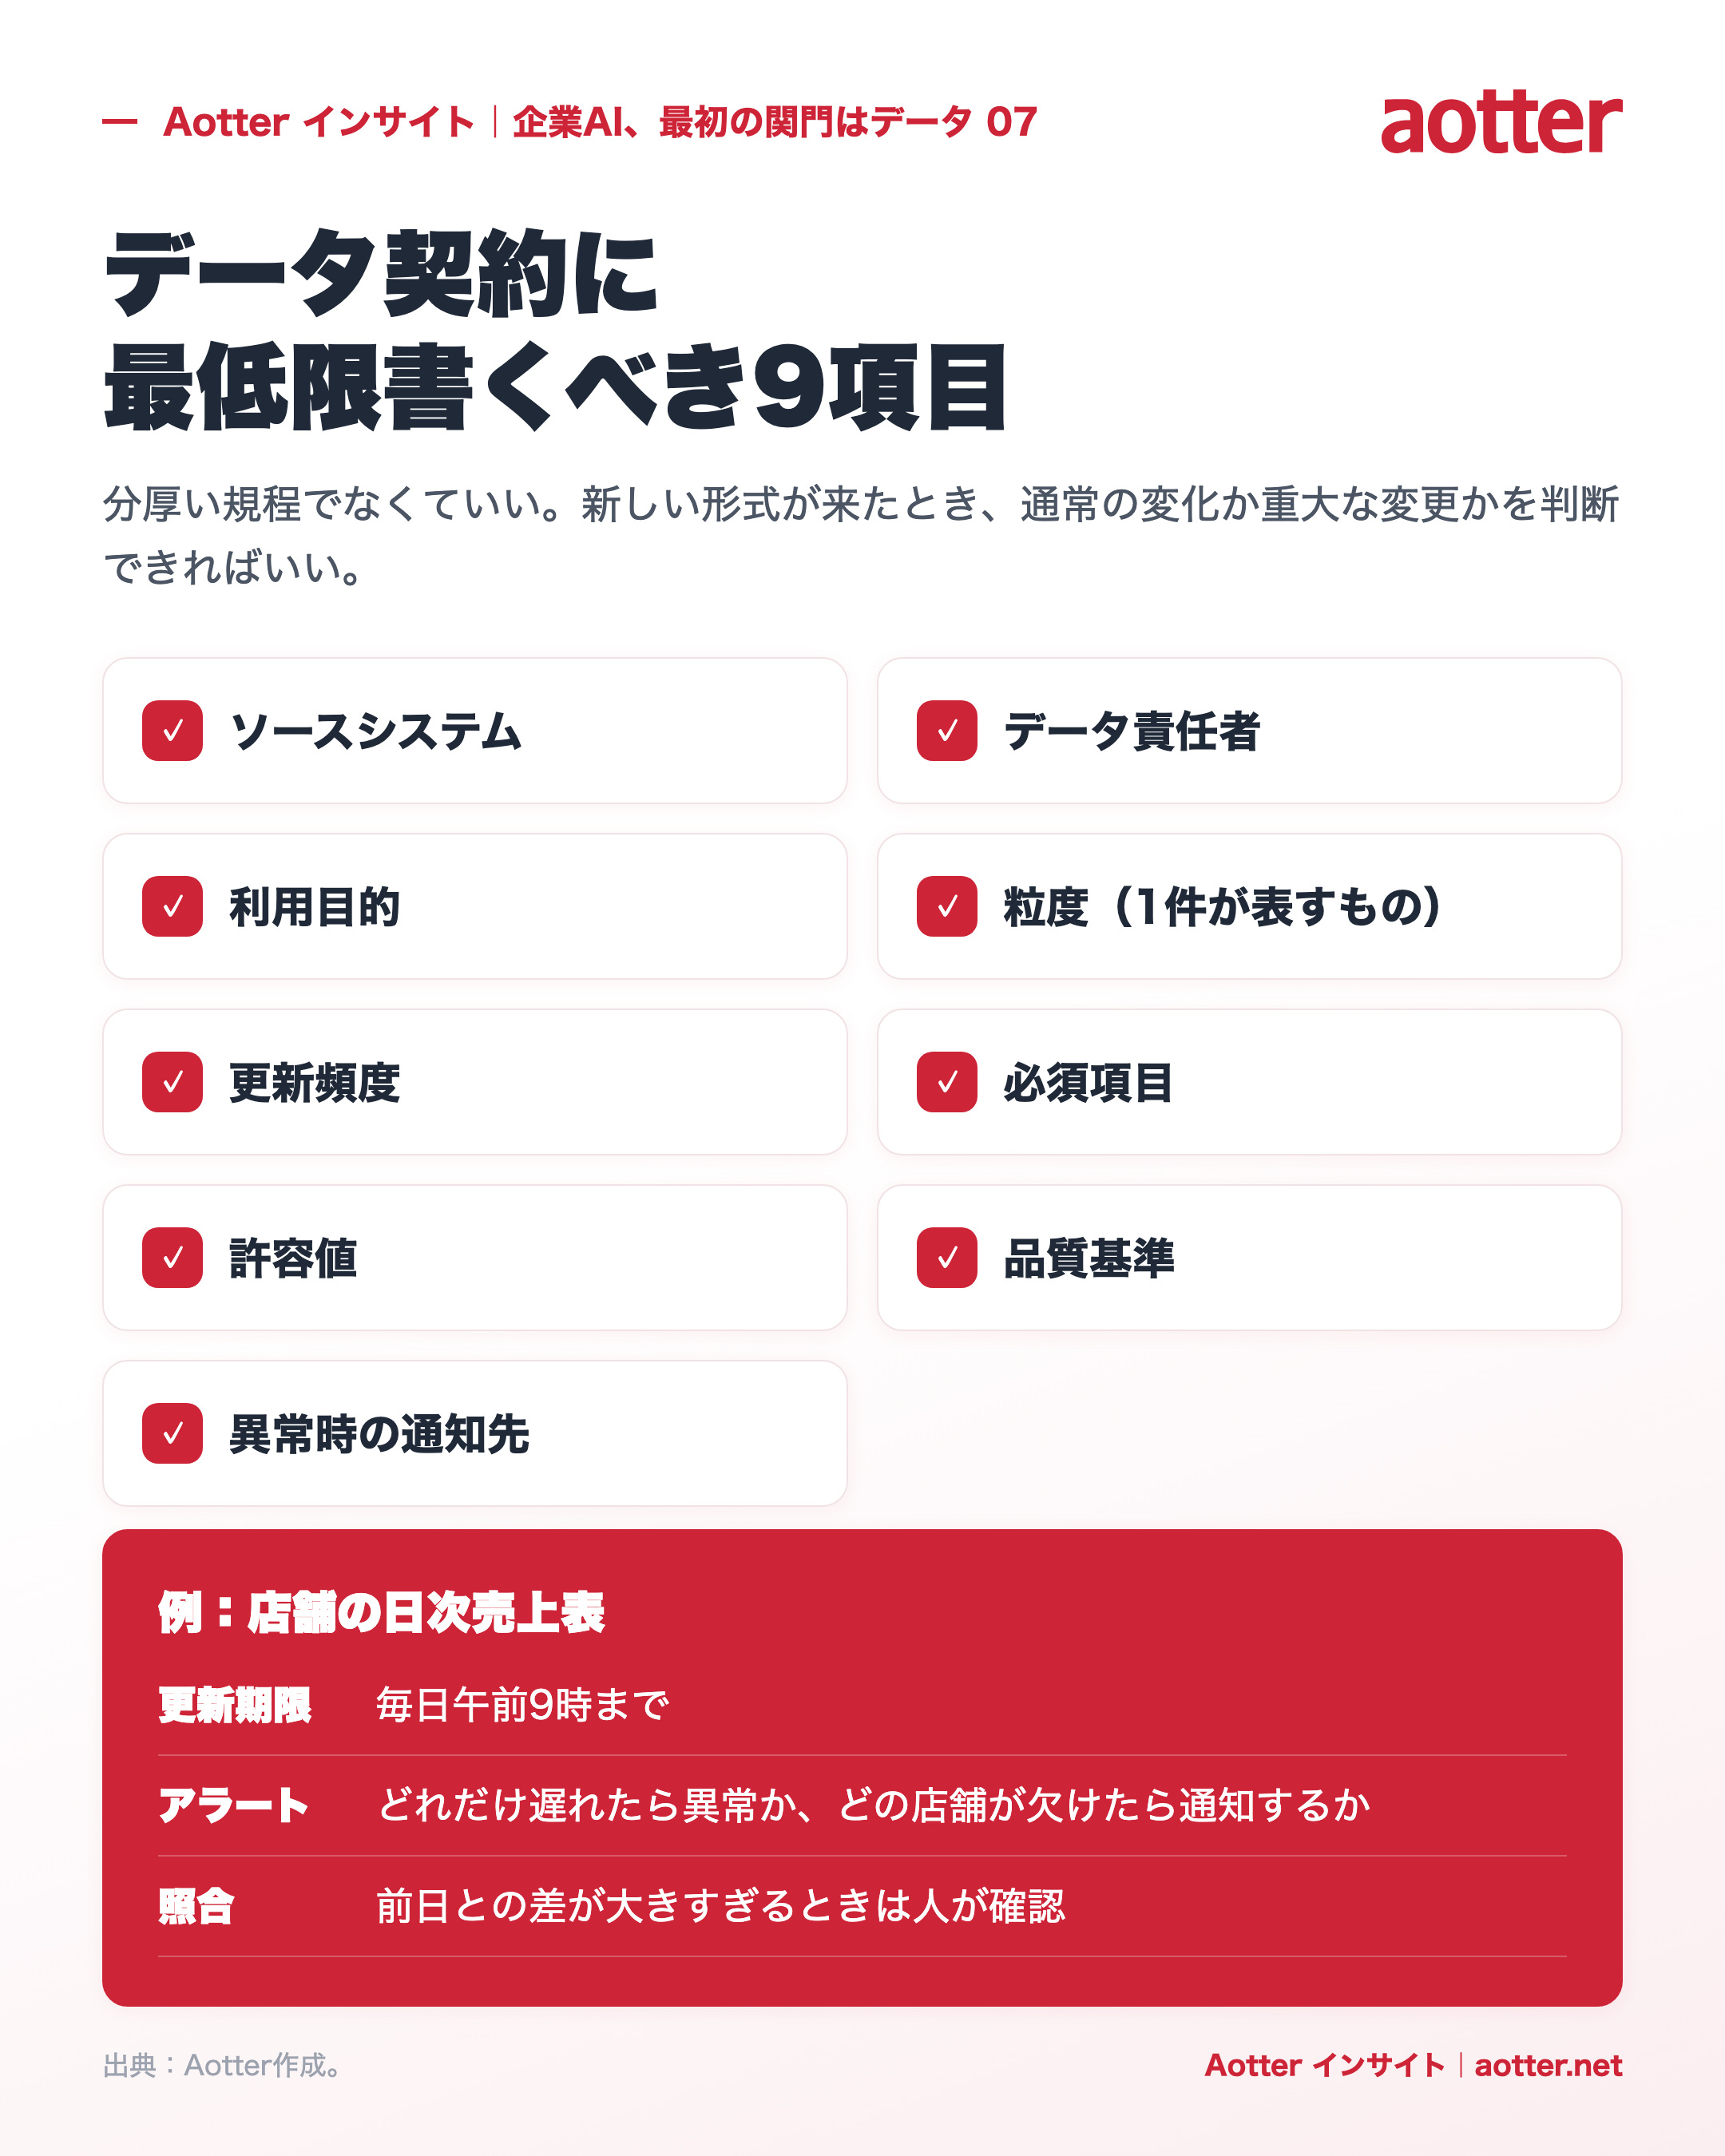
ガバナンスを実行可能な作業にするために、企業は重要なデータセットごとに簡潔なデータ契約を作成できます。契約は分厚い規範書として書く必要はありませんが、少なくともソースシステム、データ責任者、使用目的、各データが表す粒度、更新頻度、必須列、許容値、品質の閾値、データ異常時に誰に通知すべきかを列挙すべきです。新しい Excel 形式や列のバージョンが入ってきたとき、チームはこれが正常な進化なのか、それともインポートを一時停止すべき重大な変更なのかを判断できるようになります。
例えば、店舗ごとの日次売上表が毎日午前九時前に更新されると約束されているなら、企業はどれくらいの遅延を異常とみなすか、どの店舗が欠けていたら先にアラートを出すべきか、金額が前日とどれくらい差があったら照合が必要かを定義すべきです。商品在庫については、マイナス在庫、マッチしない商品コード、不合理な単日変動などのチェックを設定できます。これらの閾値は、すべての特殊なケースを一律にエラーとして扱うためのものではなく、責任者がどの差異を自動的に受け入れられるか、どれを必ず先に確認すべきかを知るためのものであり、データ品質が月末になって初めて誰かに発見されるという事態を避けるためのものです。
権限も任務に応じて分解すべきであり、単に「管理者」と「一般ユーザー」に分けるだけではいけません。財務責任者は会社全体の集計売上を見る必要があるかもしれませんが、店長は自分の店舗だけを見ればよく、分析担当者は匿名化された顧客セグメントデータを使用できるものの、電話番号や住所を取得する必要はないかもしれません。ロールベースの権限がデータセット、列、または行のレベルまで細かく設定できれば、異なる職務が業務を完了するために必要な最小限のデータだけを取得できるようになります。機密性の高い列については、マスキング、仮名化、集計クエリも検討し、データ漏洩後の直接識別のリスクを下げることができます。
操作記録も同様に、有用に設計されるべきです。「誰かがシステムを使用した」ということだけを記録するのでは、問題を追跡するには不十分です。企業はさらに、どの元データが処理されたか、どのルールのバージョンが適用されたか、どの行が隔離されたか、誰が再実行を承認したか、最終的にどのレポートやクエリが影響を受けたかを知る必要があるかもしれません。AI が問答に参加する際には、クエリの内容、モデルのソース、返されたデータの範囲、ダウンロード行為がポリシーに従って保存されているかどうかも確認する必要があります。監査ログもまた機密情報を含む可能性があり、それがデータを保護するために使われるからといって、ログ自体の権限と保存期限を無視してはいけません。
最後に、企業はデータの保存、削除、修正を同じライフサイクルに組み込むべきです。個人情報が必要な保存期間を超えたとき、顧客が削除を要求したとき、あるいは上流のシステムが取引記録を修正したとき、元のレイヤー、クリーニング後のデータ、集計表、既にスケジュールされたレポートはどう同期処理すべきでしょうか?バックアップ内のデータはいつローテーションされるのか?履歴レポートは法律上必ず保存しなければならないのか?これらの問題は導入前に法務、情報セキュリティ、ビジネス責任者と確認しておくのが望ましいです。データウェアハウスはデータを統合できますが、ガバナンス制度は統合後のデータが依然として企業の規範に従って使用されることを保証するものです。
 AIアドバイザリー · Powered by MCP
もっと深く知りたい?「AOTTERSMAN」をあなたのAIアドバイザーに
この記事の詳細な推論と実践チェックリストは、AOTTERSMANナレッジベースに収録されています。MCPを導入すれば、お使いのAIアシスタント(Claude / Cursor / Gemini…)がAOTTERSMANの思考フレームワークを直接活用——常時オンラインのAIアドバイザーがもう一人増えるイメージです。
データ主権はあなたの手に
モデルは社内に配置され、データがネットワークの外に出ることはありません。安心してAIを導入できます。