企業がAIを導入する際、最初の壁はモデルではなく、Excelに散らばったデータである
企業のAI導入について話すとき、多くの人はまずどのモデルを選ぶかを尋ねがちです。しかしここ数年、企業とやり取りする中でよく見かける最初の実際的な問題は、「会社のデータは一体どこにあるのか?それが何を意味するのか誰が知っているのか?」ということです。
私たちが最も重視する六つのプロダクト特徴
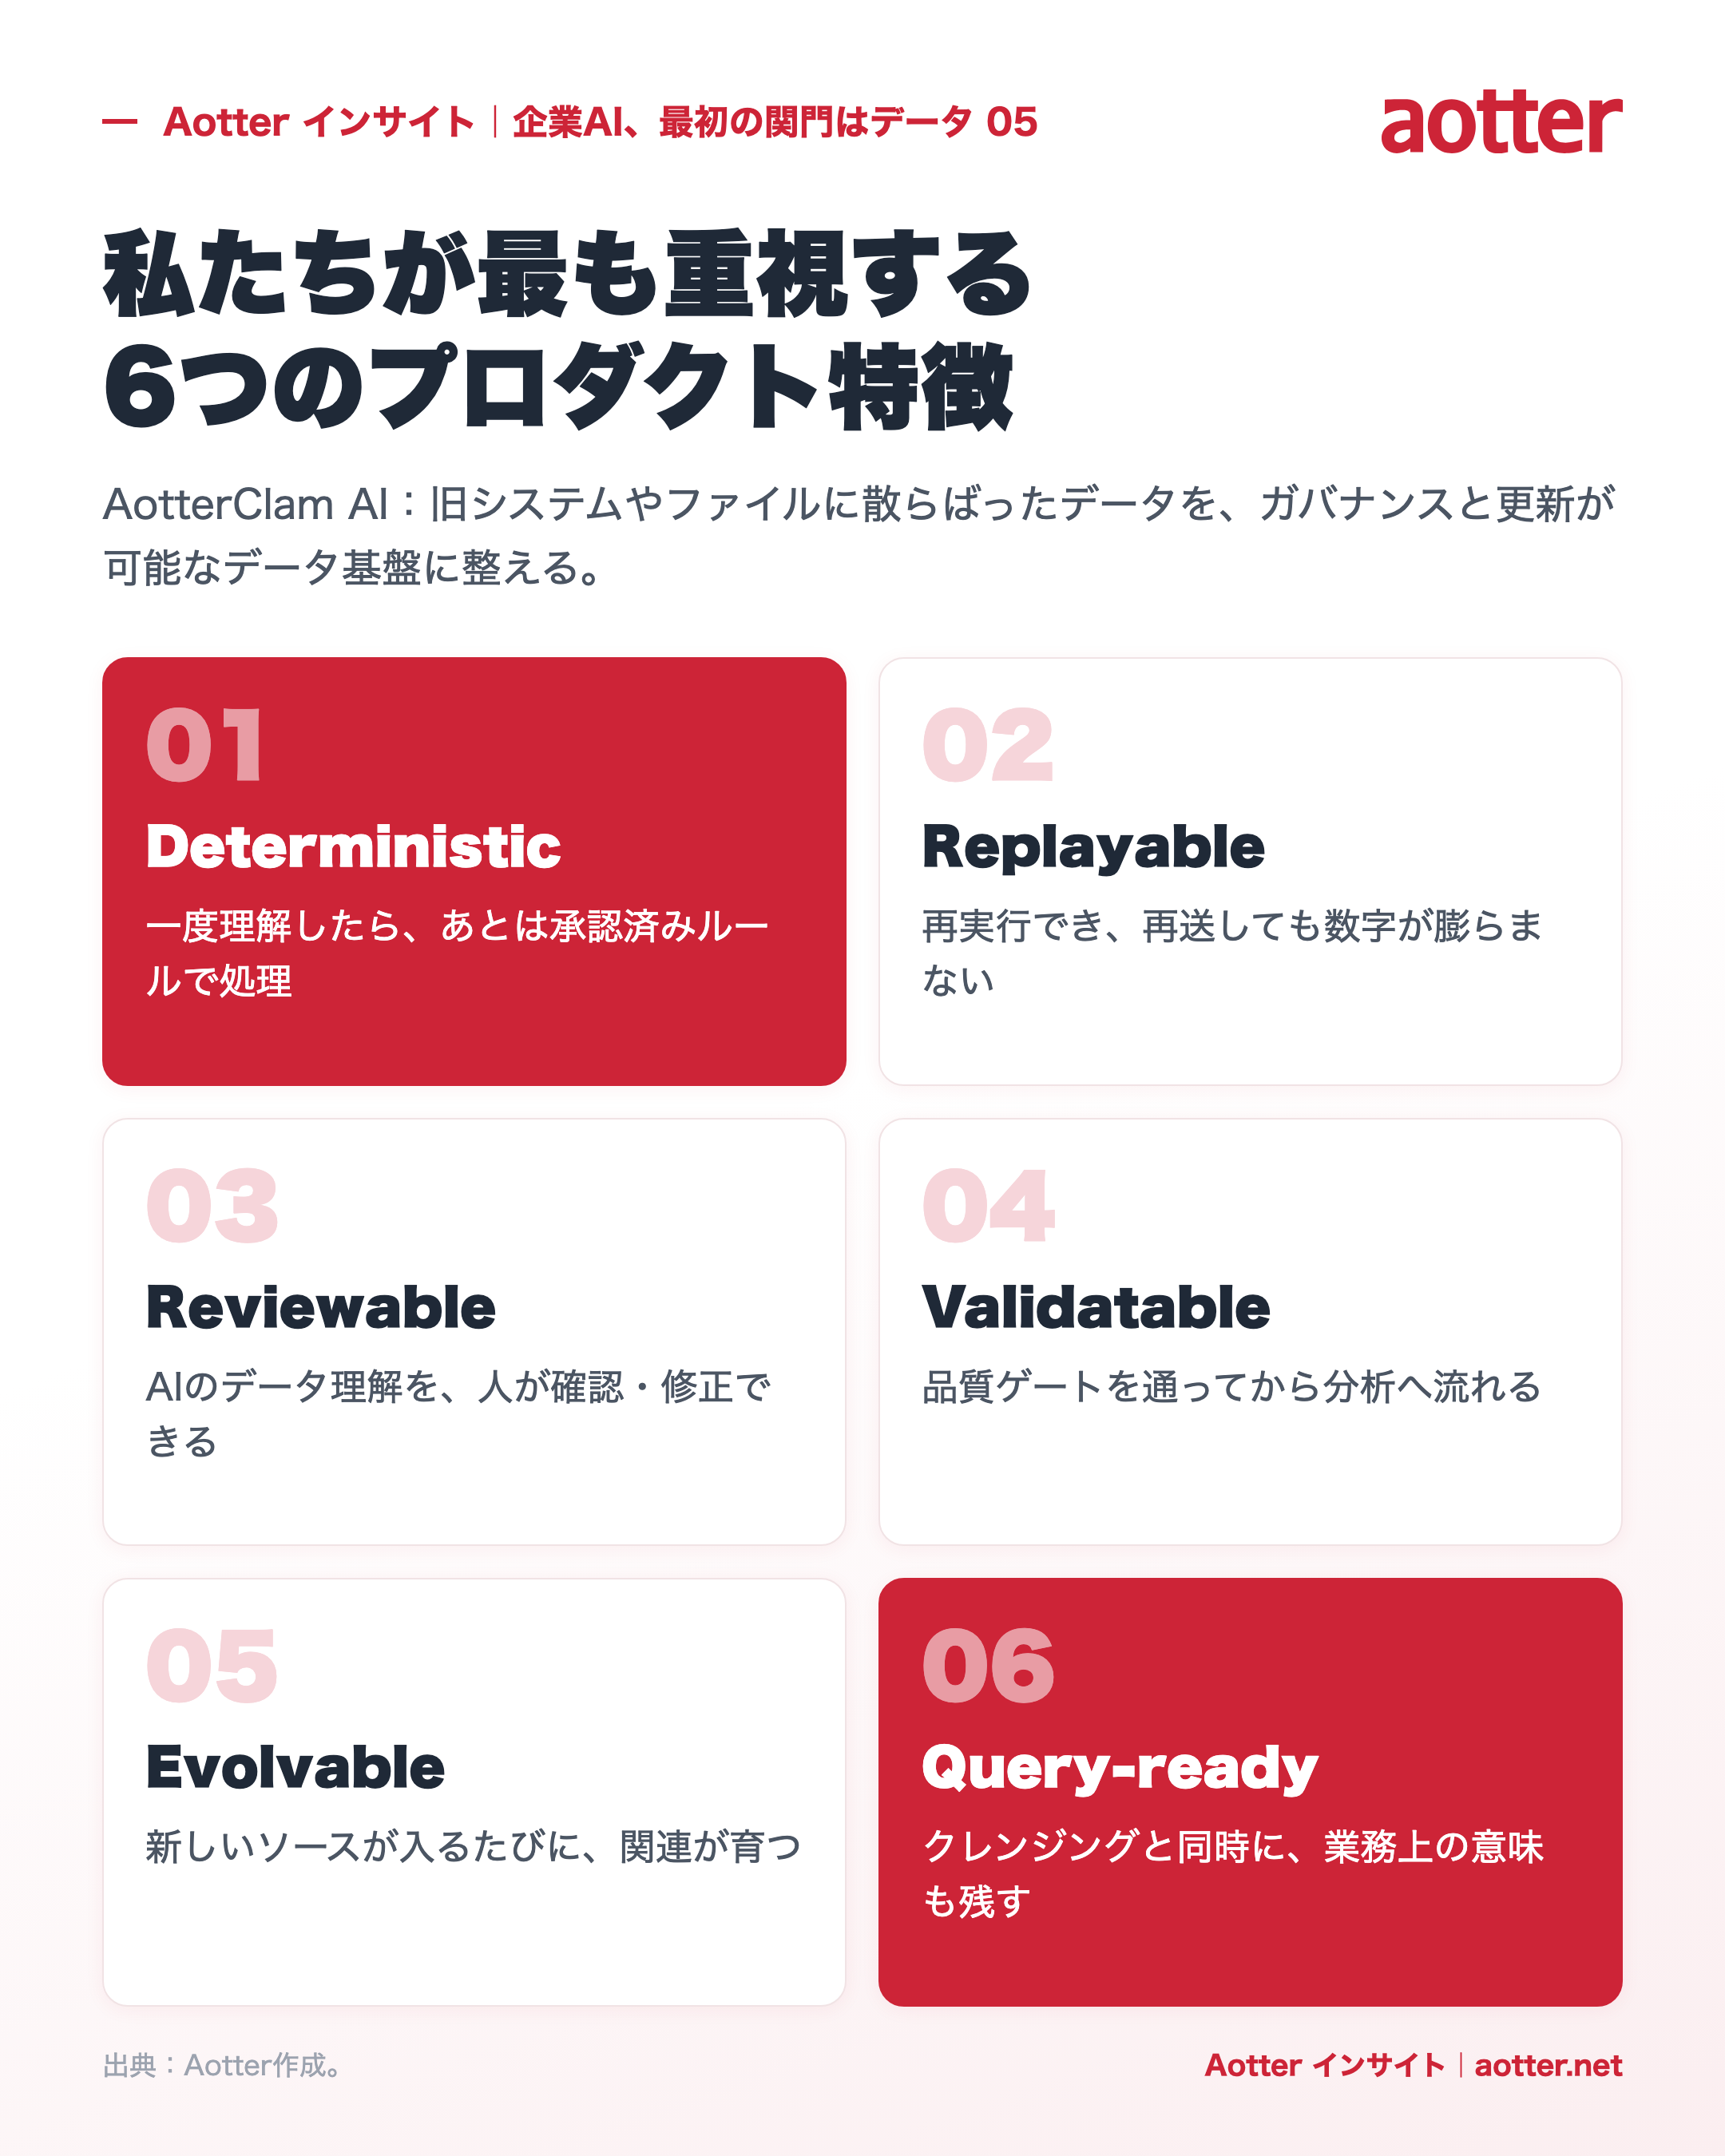
1. Deterministic:一度理解したら、以降は承認済みルールで処理
初めて見知らぬ表に出会ったとき、AI は可能性のあるタイトル行、列名、日付形式、合計行、データの粒度を識別するのを支援できます。それは推測をそのまま正式な真実として扱うのではなく、まず検証可能な定義を提示します。ユーザーが「各行は何を表しているか」「どの列が実際の金額か」「どの行は分析に含めるべきでないか」を確認した後、システムはこれらの判断を正式なルールとして保存します。
次回同じ形式のファイルが来たとき、データパイプラインは承認済みの定義に従って実行され、毎回モデルのリソースを消費して各列の用途を推測し直す必要はありません。これが deterministic の核心です。毎回のクリーニングを新しい対話として扱うのではなく、既にビジネス側の確認を経たステップを繰り返し実行可能な手順にするのです。
しかし deterministic は永遠にエラーが発生しないという意味ではありません。データソースが仕様変更されることもあれば、サプライヤーが列名を変更することもあり、同じシステムでも部門ごとにエクスポートされるファイル形式が異なることさえあります。固定ルールが互換性のない変化に遭遇したとき、正しい対応はエラーデータを無理やり倉庫に押し込むことではなく、構造の変化を検出し、影響を受けたデータを一時停止または隔離し、人に確認を求めることです。安定性は明確なルールと変更管理から来るものであり、「AI が一度学習すれば、以降は何も管理しなくていい」と主張することではありません。
2. Replayable:再実行可能であり、かつ再送信によって数値が水増しされない
企業のデータインポートではほぼ必ず再送信に遭遇します。レポートを間違えて送って再送したり、同じファイルを二回アップロードしたり、スケジュール実行が中断して再実行したり、経理担当が月末に先月の記録を修正したりするのは日常的な状況です。もしシステムが受け取った内容を単純にデータテーブルの後ろに追加するだけなら、一度再実行するだけで売上、注文数、在庫量が何もないところから倍増してしまう可能性があります。
そのため、システムはどのような条件で同一のビジネスデータを識別できるかを知る必要があります。注文番号と商品明細番号の組み合わせかもしれませんし、店舗コード、取引日、連番を組み合わせる必要があるかもしれません。この識別方式は企業のビジネス定義によって決定されるべきで、ファイル名や行番号だけを永続的な一意キーとして扱うべきではありません。同じレコードが再び現れたとき、システムはルールに従って既存のデータを更新するか、それを重複項目として識別できる必要があり、無条件に積み重ねるべきではありません。
再実行可能であることは、修正にも正式なフローを与えます。仮に過去に日付をテキストとして読み込んでしまった、値引き欄の減算を漏らしていた、あるいは同一注文の商品行が誤って合計されていたことに気づいたとしても、元のファイル、処理定義のバージョン、実行記録を保存しておけば、先にルールを修正し、影響を受けた期間のデータを再処理することができます。これによりデータの結果は追跡可能となり、企業は「この数字はどこから来たのか」「どのバージョンのルールがこのレポートを生成したのか」に答える機会を持てます。
注意すべきは、データを再生可能にすることは、すべての元ファイルを無制限に保存する理由にはならないということです。元データに個人情報が含まれているかどうか、保存期限をどう設定するか、誰が再実行する権限を持つか、旧バージョンは削除またはマスキングすべきかどうかは、すべて企業の既存のデータポリシーに組み込まれなければなりません。再実行能力が解決するのは技術的な復元可能性であり、企業のデータ保存と個人情報管理の責任を自動的に完了させるものではありません。
3. Reviewable:AI がデータをどう理解しているかを、人がチェックし修正できる
多くのデータ整理の経験は、ベテラン社員の頭の中だけに存在しています。皆、「レポートの上のあの二行は要らない」と知っていたり、ある列が「状態」と書かれていても実は出荷状態を表していると知っていたり、二つのリストをどのコードで対応させればよいか知っていたりします。短期的に見れば、その同僚に聞くのが最も早い方法です。しかし長期的に見れば、これらの重要な知識が記録されなければ、業務の引き継ぎ、組織の調整、人員の離職とともに消えてしまいます。
Reviewable の意味は、AI のデータに対する理解を広げてチェックできるようにすることです。列はどう命名されているか、列の型は何か、各行は注文を表すのか注文品目を表すのか、どの列を合計できるか、どのデータを除外すべきか、異なるソースをどう接続するか。ビジネス担当者はドメイン知識を補足でき、データ担当者は技術設定を確認でき、管理者は指標の定義が経営上の口径に合致しているかを確認できます。これは承認プロセスを増やすためではなく、もともと口頭伝承にのみ頼っていたデータルールを、組織が共同でメンテナンスできる資産に変えるためです。
検証可能性には変更記録も含まれるべきです。ある列の定義が「売上」から「返金を控除した純売上」に変わったとき、企業は誰がいつルールを調整したのか、影響を受けたダッシュボードはどれか、旧レポートが依然として旧口径を採用しているかどうかを知ることができるべきです。データ定義は一度作ったら永遠に変わらないものではなく、ビジネスプロセス、プロダクト形態、法規要件とともに進化していきます。追跡可能なバージョン管理は、同じ名称が異なる部門でそれぞれ異なる数字を表すことを防げます。
4. Validatable:データはまず検査を通過してから、分析と AI の問答フローに流れる
自動化は単にエラーをより速く走らせるだけであってはいけません。データ列が存在しない、日付形式が期待と合わない、商品コードが対応する商品を見つけられない、注文総額と明細の合計との差が大きすぎる、これらの問題はすべてデータが分析層に入る前に指摘されるべきです。
私たちは検証を品質ゲートと考えています。基本チェックでは列が存在するか、型が正しいか、必須列に空値がないか、主キーが重複していないかを確認できます。さらにビジネスルールを加えます。例えば取引日はインポート日より大幅に後になってはいけない、割引は元の金額より大きくてはいけない、キャンセルされた注文は有効な売上に計上すべきでない、各店舗は毎週データが必ずあるべき、といったものです。財務や在庫データについては、元の ERP の集計数値との照合も重要です。そうしなければ、形式上は正しく見えるファイルでも、ある変換ステップで丸ごとデータが漏れている可能性があります。
検証結果は「合格」か「不合格」の二択だけである必要はありません。エラーが取引金額や個人識別情報のような高リスクの列に関わる場合、システムはまずデータを隔離し、人に確認を求めることができます。重要でない備考欄に新しい形式が増えただけであれば、警告をマークしつつ他の列の処理を続けることもできます。警告のレベルとビジネスへの影響を分けることで、「完全に停止する」か「すべての異常を無視する」かという二者択一を避けられます。
人工知能科技基金会は 2025 年台湾産業 AI 化調査の中で、専門家インタビューを通じてデータ標準、データ品質、応用シナリオは一緒に考慮しなければならないと述べています。データは保存されているだけではガバナンスが完了したことにはならず、実際の意思決定を支えられるかどうか、責任者がいるかどうか、データが変化したときに発見し修正できるかどうかも知る必要があります。6
5. Evolvable:新しいソースが入ってきても、既存のデータが段階的に新しい関連を育てられる
企業はすべての部門がデータの棚卸しを完了するまで待ってから、最初の分析プロジェクトを始める必要はありません。最初は売上明細しかなくても、まず「最近どの商品がよく売れているか」に答えられます。後で在庫表を加えれば、「どの商品が売上増加しているのに、在庫が徐々に不足しているか」が見えるようになります。さらに顧客や会員データを接続すれば、「異なる顧客層が何を買っているか、リピート購入の間隔はどれくらいか」を理解する機会が得られます。データモデルは本当の必要性に応じて段階的に拡張でき、プロジェクト開始時に企業のすべてのソースを一度に揃える必要はありません。
しかし、新しいデータを追加するというのも、似たようなテキスト列を持つ二つの表を単純に直接接続すればよいというものではありません。商品名には略称、スペース、新旧の品名があるかもしれず、異なるシステムの顧客番号もそれぞれ独立しているかもしれません。関連を構築する際は、双方の識別キーが安定しているか、データが一対多か多対多か、履歴記録を保持する必要があるか、マッチしなかった項目をどう処理するかを確認する必要があります。「台北店舗」と「台北店」を誤って二つの異なる店舗として扱ったり、同名の二人の顧客を合併してしまったりすると、後続の AI による解釈がいくら流暢でも、データモデルの誤りを救うことはできません。
モデルを進化可能にするもう一つの利点は、企業が新しいソースを追加するたびにデータの価値を拡大するチャンスとして捉えられることです。以前は月間売上しかなかったとき、管理者は結果しか見られませんでした。プロモーション活動と在庫変化を加えれば、活動前後の在庫回転と売上の差異を比較できます。さらにカスタマーサービスのフィードバックを取り込めば、人気商品の返品理由まで追跡できます。データ間の関連が段階的に増えるにつれ、古いデータも新しい文脈によってより多くの質問に答えられるようになるかもしれません。
6. Query-ready:データをクリーニングする際、ビジネスの意味も同時に残しておく
空白を削除し、日付を統一し、誤字を修正するのは、データ整理のほんの一部に過ぎません。もしデータが倉庫に入った後も「商品」「注文」「顧客」がそれぞれ何を指すのか分からず、どの列が正式な売上なのか分からず、二つの表をどう接続すべきか明確でなければ、AI の問答は毎回また一から推測し直すことになり、一見合理的に見える答えの中で気づきにくいミスを犯す可能性さえあります。
そこで私たちは、データクリーニングの段階で、最も基本的な意味論レイヤー(semantic layer)を一緒に構築することを目指しています。意味論レイヤーはデータの列を企業が実際に使用している概念に変換します。一件の売上の粒度は何か、純売上はどう計算するか、返金はどう控除すべきか、商品分類はどのコードを採用するか、日付は取引日を基準にするか出荷日を基準にするか、そして異なるデータセットの関連はどう構築するか。こうすることの目的は、BI ツールや AI が照会する際に明確なビジネス上の文脈を持てるようにし、列名を見ただけで勝手に推測しなくてもよいようにすることです。
同じ指標でも、異なる状況下で異なるバージョンを持つことがあります。財務部門は請求書で計上された売上を基準にするかもしれませんし、運営チームは既に出荷された注文を基準に売上を観察するかもしれません。マーケティング部門はキャンセル注文を控除した後の活動コンバージョンを見たいと思うかもしれません。これらの口径を無理に一つの答えに統一する必要はありません。より現実的なやり方は、各指標の名称、計算方法、適用シナリオ、責任者を明確にし、ユーザーが質問する際にシステムがどの口径を適用すべきか分かるようにすることです。
データの粒度、関連、指標の計算方式が明確に記述されると、AI の仕事は中国語(日本語)の質問をデータベースクエリに翻訳するだけではなくなります。意味論レイヤーに基づいて、質問の中で言及されているのがどの種類の売上なのか、どの期間なのか、どの商品の次元なのか、どのデータを混ぜて加算すべきでないかを識別することもできます。もちろん、意味論レイヤーも依然としてビジネス責任者の承認が必要です。それは列名からすべてのビジネスロジックを自動的に導き出せる魔法のモジュールではありません。
 AIアドバイザリー · Powered by MCP
もっと深く知りたい?「AOTTERSMAN」をあなたのAIアドバイザーに
この記事の詳細な推論と実践チェックリストは、AOTTERSMANナレッジベースに収録されています。MCPを導入すれば、お使いのAIアシスタント(Claude / Cursor / Gemini…)がAOTTERSMANの思考フレームワークを直接活用——常時オンラインのAIアドバイザーがもう一人増えるイメージです。
データ主権はあなたの手に
モデルは社内に配置され、データがネットワークの外に出ることはありません。安心してAIを導入できます。