企業がAIを導入する際、最初の壁はモデルではなく、Excelに散らばったデータである
企業のAI導入について話すとき、多くの人はまずどのモデルを選ぶかを尋ねがちです。しかしここ数年、企業とやり取りする中でよく見かける最初の実際的な問題は、「会社のデータは一体どこにあるのか?それが何を意味するのか誰が知っているのか?」ということです。
企業の AI 導入について語るとき、多くの人は「どのモデルを選ぶべきか?ChatGPT を使うべきか、Claude か、それとも自前で構築するか?」とすぐに尋ねがちです。しかし、ここ数年企業とやり取りしてきた中でよく見かける最初の実際的な問題は、モデルのランキングではなく、もっと基本的で、かつ見落とされがちなことです。つまり、会社のデータは一体どこにあるのか?誰がそれが何を意味するのか知っているのか?信頼できる形で整理し、異なる部門や異なるツールで繰り返し利用できるようにできるのか、ということです。
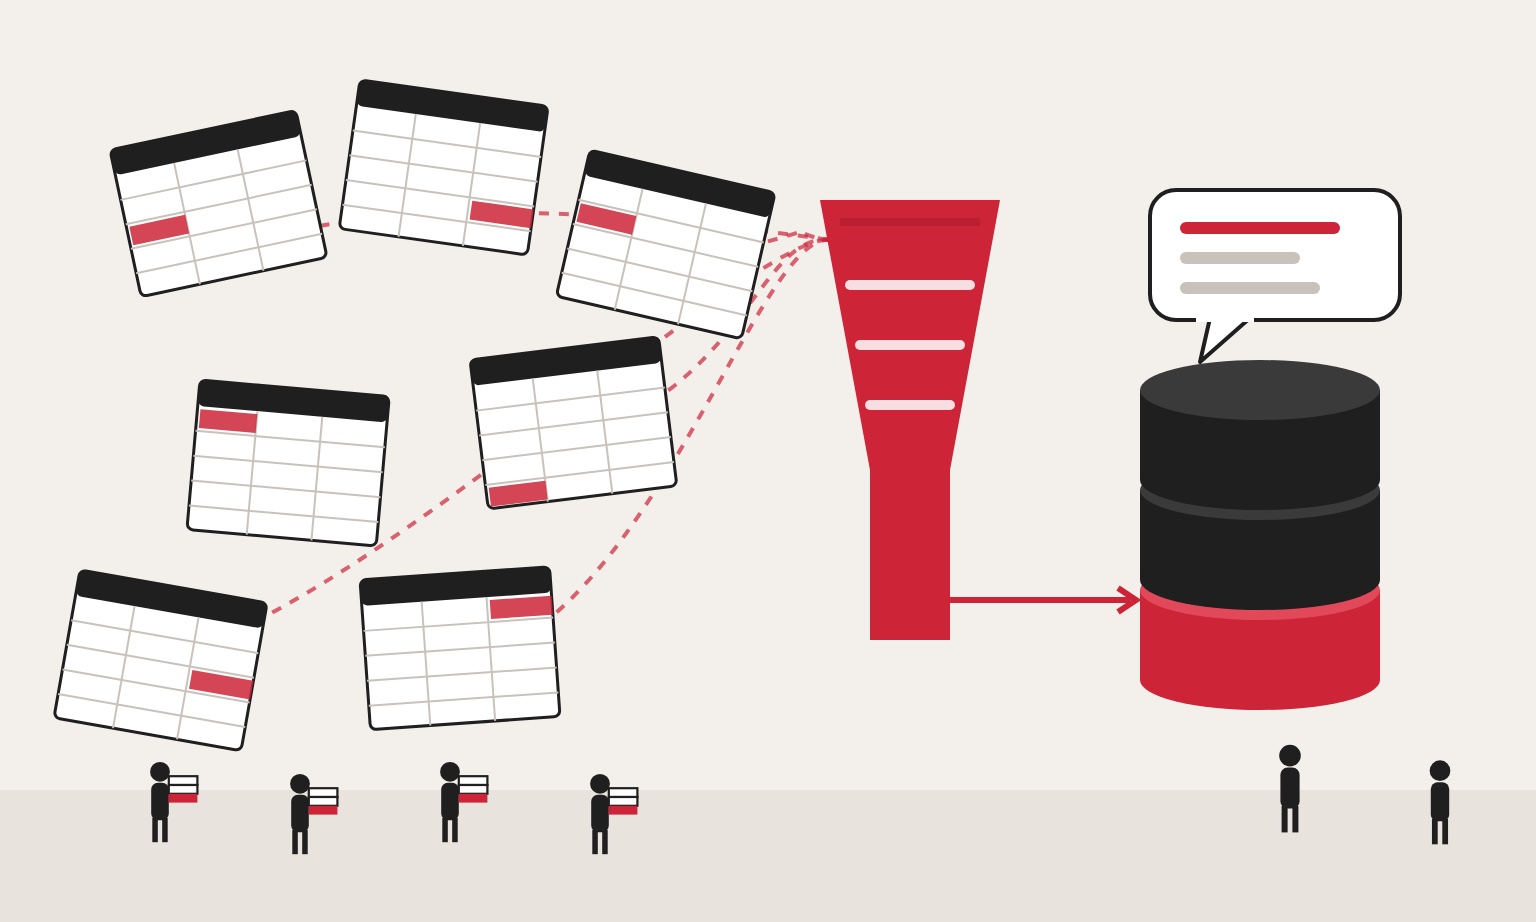
多くの企業はデータが無いわけではありません。むしろ逆で、データは多すぎるほどあり、各部門がそれぞれ独自のバージョンを持っています。ERP には一つ、POS には一つ、EC のバックエンドにも一つ、営業担当が送ってくる Excel もまた別のもの。人事、カスタマーサービス、在庫、会計もそれぞれ使い慣れたワークシートを管理しています。普段レポートを作成する必要があるとき、まずファイルを揃え、手作業で列を整理し、小計行を削除し、コードを照合し、日付形式を確認してから、やっと本当のビジネス上の質問に答え始めます。データは既に存在しているのに、それを機械が理解でき、同僚も信頼できる形に「翻訳」するために、大量の人手をまず費やさなければならないのです。
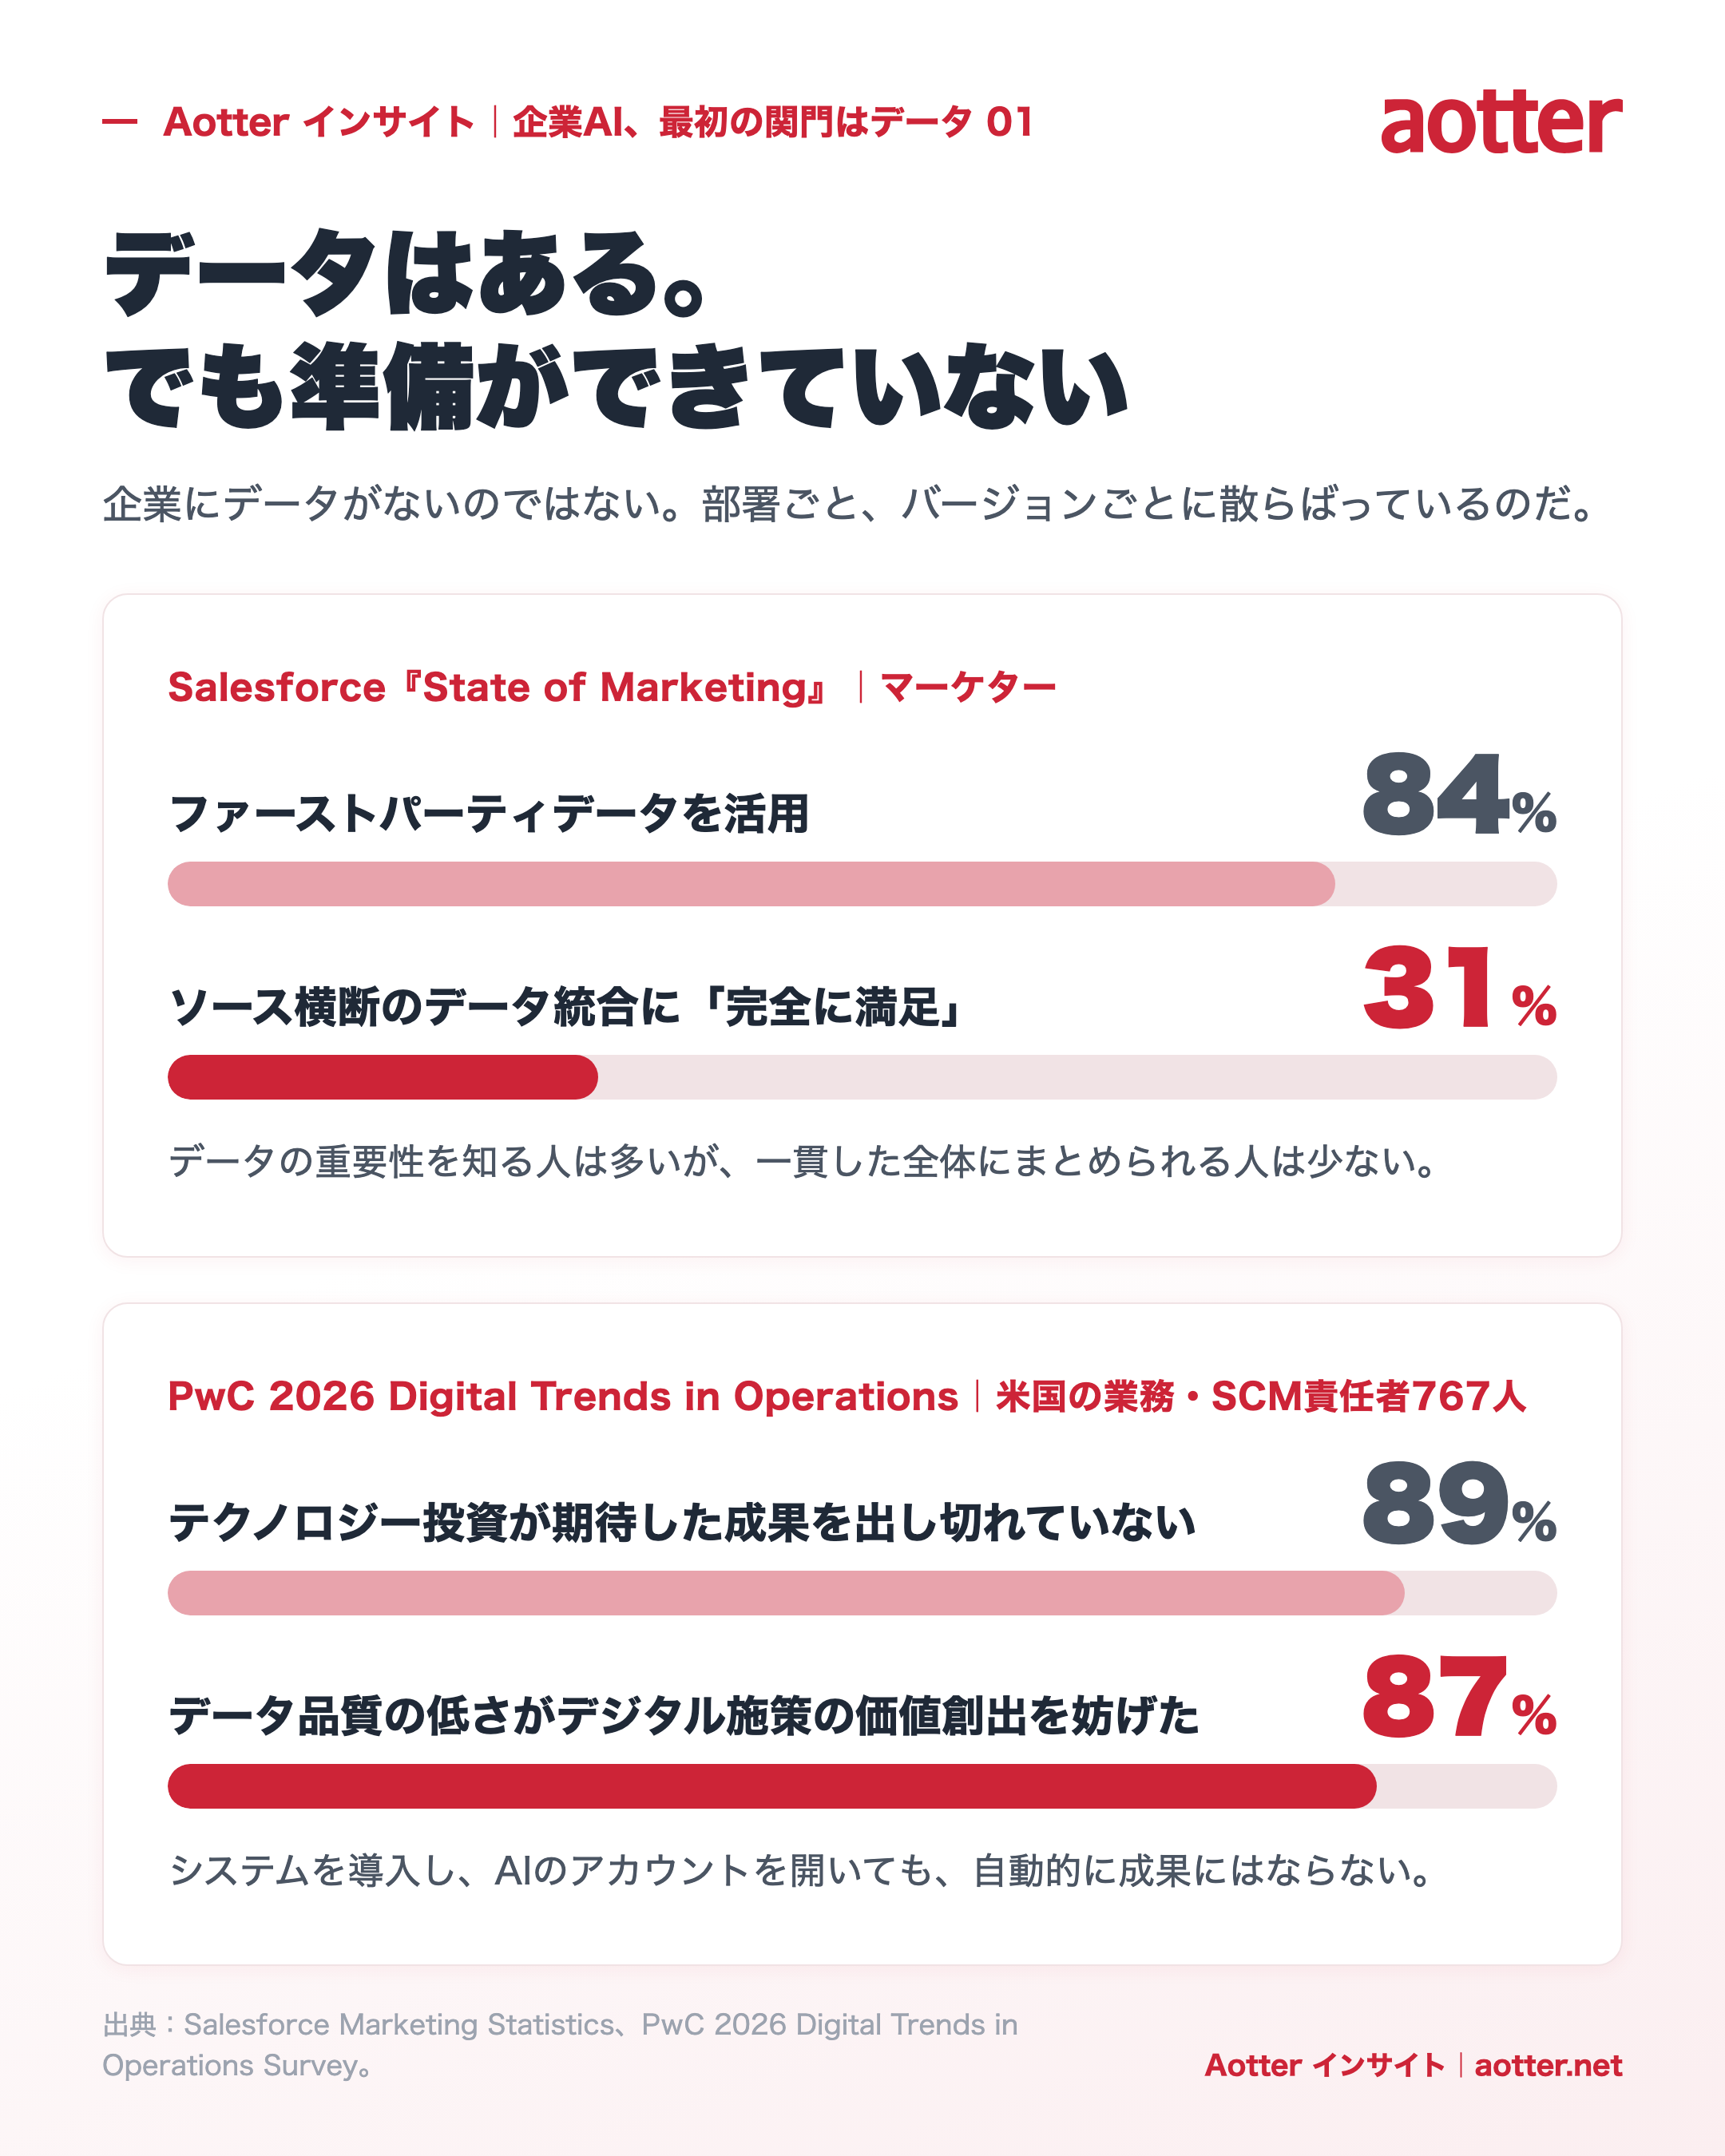
このギャップは、私たちが顧客の現場で目にした個別の事例にとどまりません。Salesforce の《State of Marketing》関連の統計によると、84% の回答したマーケティング担当者がファーストパーティデータを使用している一方、クロスソースのデータ統合能力に完全に満足しているのはわずか 31% にすぎません。この二つの数字を並べて見ると非常に興味深いものがあります。企業は徐々に自社のデータの重要性を認識し始めているものの、依然として多くのチームが各所のデータを一貫性のある、使用可能な全体として整理できていないのです。1
PwC が 2026 年に米国の 767 人の運営・サプライチェーン責任者を対象に行った調査も、同様の現実を示しています。回答者の 89% が、テクノロジーへの投資がまだ当初期待していた成果を完全にはもたらしていないと述べ、87% がデータ品質の低さがデジタル計画の価値創出能力に影響していると指摘しています。これは全ての企業のデータが乱雑であるという意味ではなく、システムを導入し AI のアカウントを開通させても、データ品質、システム連携、ワークフローの処理を同時に行わなければ、投資が自動的に成果に変わるわけではないことを思い出させてくれます。2
そこで、昨年から私たちは一見それほど華やかではないものの、実際には非常に重要な仕事にスキルを投入し始めました。それは、AI が企業のデータの清掃と整理を支援することです。一年経った今、プロダクトは徐々に成熟し、私たちは AotterClam AI をリリースしました。これはもう一つのチャット画面を作ることではなく、古いシステム、レポート、ファイルに散らばったデータを、ガバナンス可能で、更新可能、かつ後続の AI や BI ツールで利用できるデータ基盤に整理することを目指しています。
なぜ皆 AI について語りながら、最終的によく Excel で詰まってしまうのか?
私たち Aotter はデータ関連の仕事を十数年行っており、データエンジニアリングとデータガバナンスの日常業務に精通しています。外部の人が私たちを知るきっかけは、おそらく AotterGirls から始まったでしょう。しかし Aotter は創作ツール、コンテンツプロダクトから、データ広告、ファーストパーティデータの活用、そして企業 AI へと歩んできましたが、その背後では一貫して同じ種類の問題を扱ってきました。つまり、情報が価値に変わる時間をどう短縮するかということです。私たちがメディアと広告テクノロジーの現場で長年ユーザー行動データを扱ってきた中で分かったのは、データを収集することは始まりに過ぎないということです。本当に難しいのは、整理、定義、権限、用途、そして将来も継続して更新できるかどうかです。10 11
ファーストパーティデータの議論は、過去はマーケティングや広告の分野でよく登場していましたが、現在ではますます企業運営の核心に近づいています。それはブランドが直接収集した会員や取引データだけでなく、企業が合法的で合理的なビジネス関係の中で蓄積した注文、在庫、カスタマーサービスのやり取り、サービス記録も含みます。これらのデータを掌握できるかどうかは、企業が自社の運営状況の中で分析能力を構築できるかどうかに関わり、毎回外部プラットフォームが提供する概略的な答えに頼る必要がなくなるかどうかに関わります。
このトレンドも「ファーストパーティ」という三文字を貼り付ければ完成するわけではありません。eMarketer が引用した 2024 年の調査によると、ある B2B マーケティング担当者の調査では、67% がデータのコンプライアンスと正確性を重要な優先事項としており、別のグローバルマーケティング担当者調査では 84% が顧客、ファーストパーティ、取引データを活用してオーディエンスを理解していると答えています。これらの数字は特定の調査対象とその時点での市場状況を反映したものであり、すべての企業が既に成熟したデータガバナンス能力を備えていることを意味するわけではありません。しかし、企業がデータの使用可能性と同時に、使用方法がコンプライアンスに適合しているか、正確であるかを気にかけ始めていることを明確に示しています。3
また私たちは特に指摘しておきたいのですが、ファーストパーティデータは「自分が手に入れたデータなら自由に使って良い」という意味ではありません。データがどこから来たのか、収集時に何を告知したのか、どのような用途での使用が許可されているのか、誰が見られるのか、どれくらい保存するのか、他のソースと連携できるのかなど、すべて明確な規範が必要です。本当に価値のあるファーストパーティデータとは、合法的で透明な関係の中で蓄積され、組織が継続的に管理できるデータ資産であり、名前を変えて過剰な収集や無制限の追跡を続けることではありません。
そして企業 AI の状況に入ると、データのボトルネックは非常に現実的な形で現れます。多くの企業が使用している基幹システムは既に何年も稼働しており、ERP、POS、倉庫や受注システムはそれぞれ独自のデータベースを持っているかもしれませんが、システム間に適切な API がなかったり、API はあっても企業に予算、権限、専任担当者がなくそれを接続できていなかったりします。実務上、現場で最もよく使われる外部出力は今もなお Excel や CSV です。毎週売上表をエクスポートしたり、毎日レポートメールを送ったり、月末に同僚が異なる部門のワークシートを統合したりしています。
データが Excel の形で提供されているからといって、それを価値のないデータとして扱うべきではありません。これらのワークシートはしばしば企業の長年の運営経験を蓄積していますが、ただ表の設計がもともと人に奉仕するためのものであり、データパイプラインのためではなかっただけです。一行目はセルを結合したタイトルかもしれず、二行目にようやく列名が来る。同じ列の中に日付、文字、注記が混在している。一つのワークシートの中に明細、小計、合計、備考が混ざっている。異なる部門が同じ列を異なる名前で呼んだり、同じ名前で異なる概念を表したりすることさえあります。
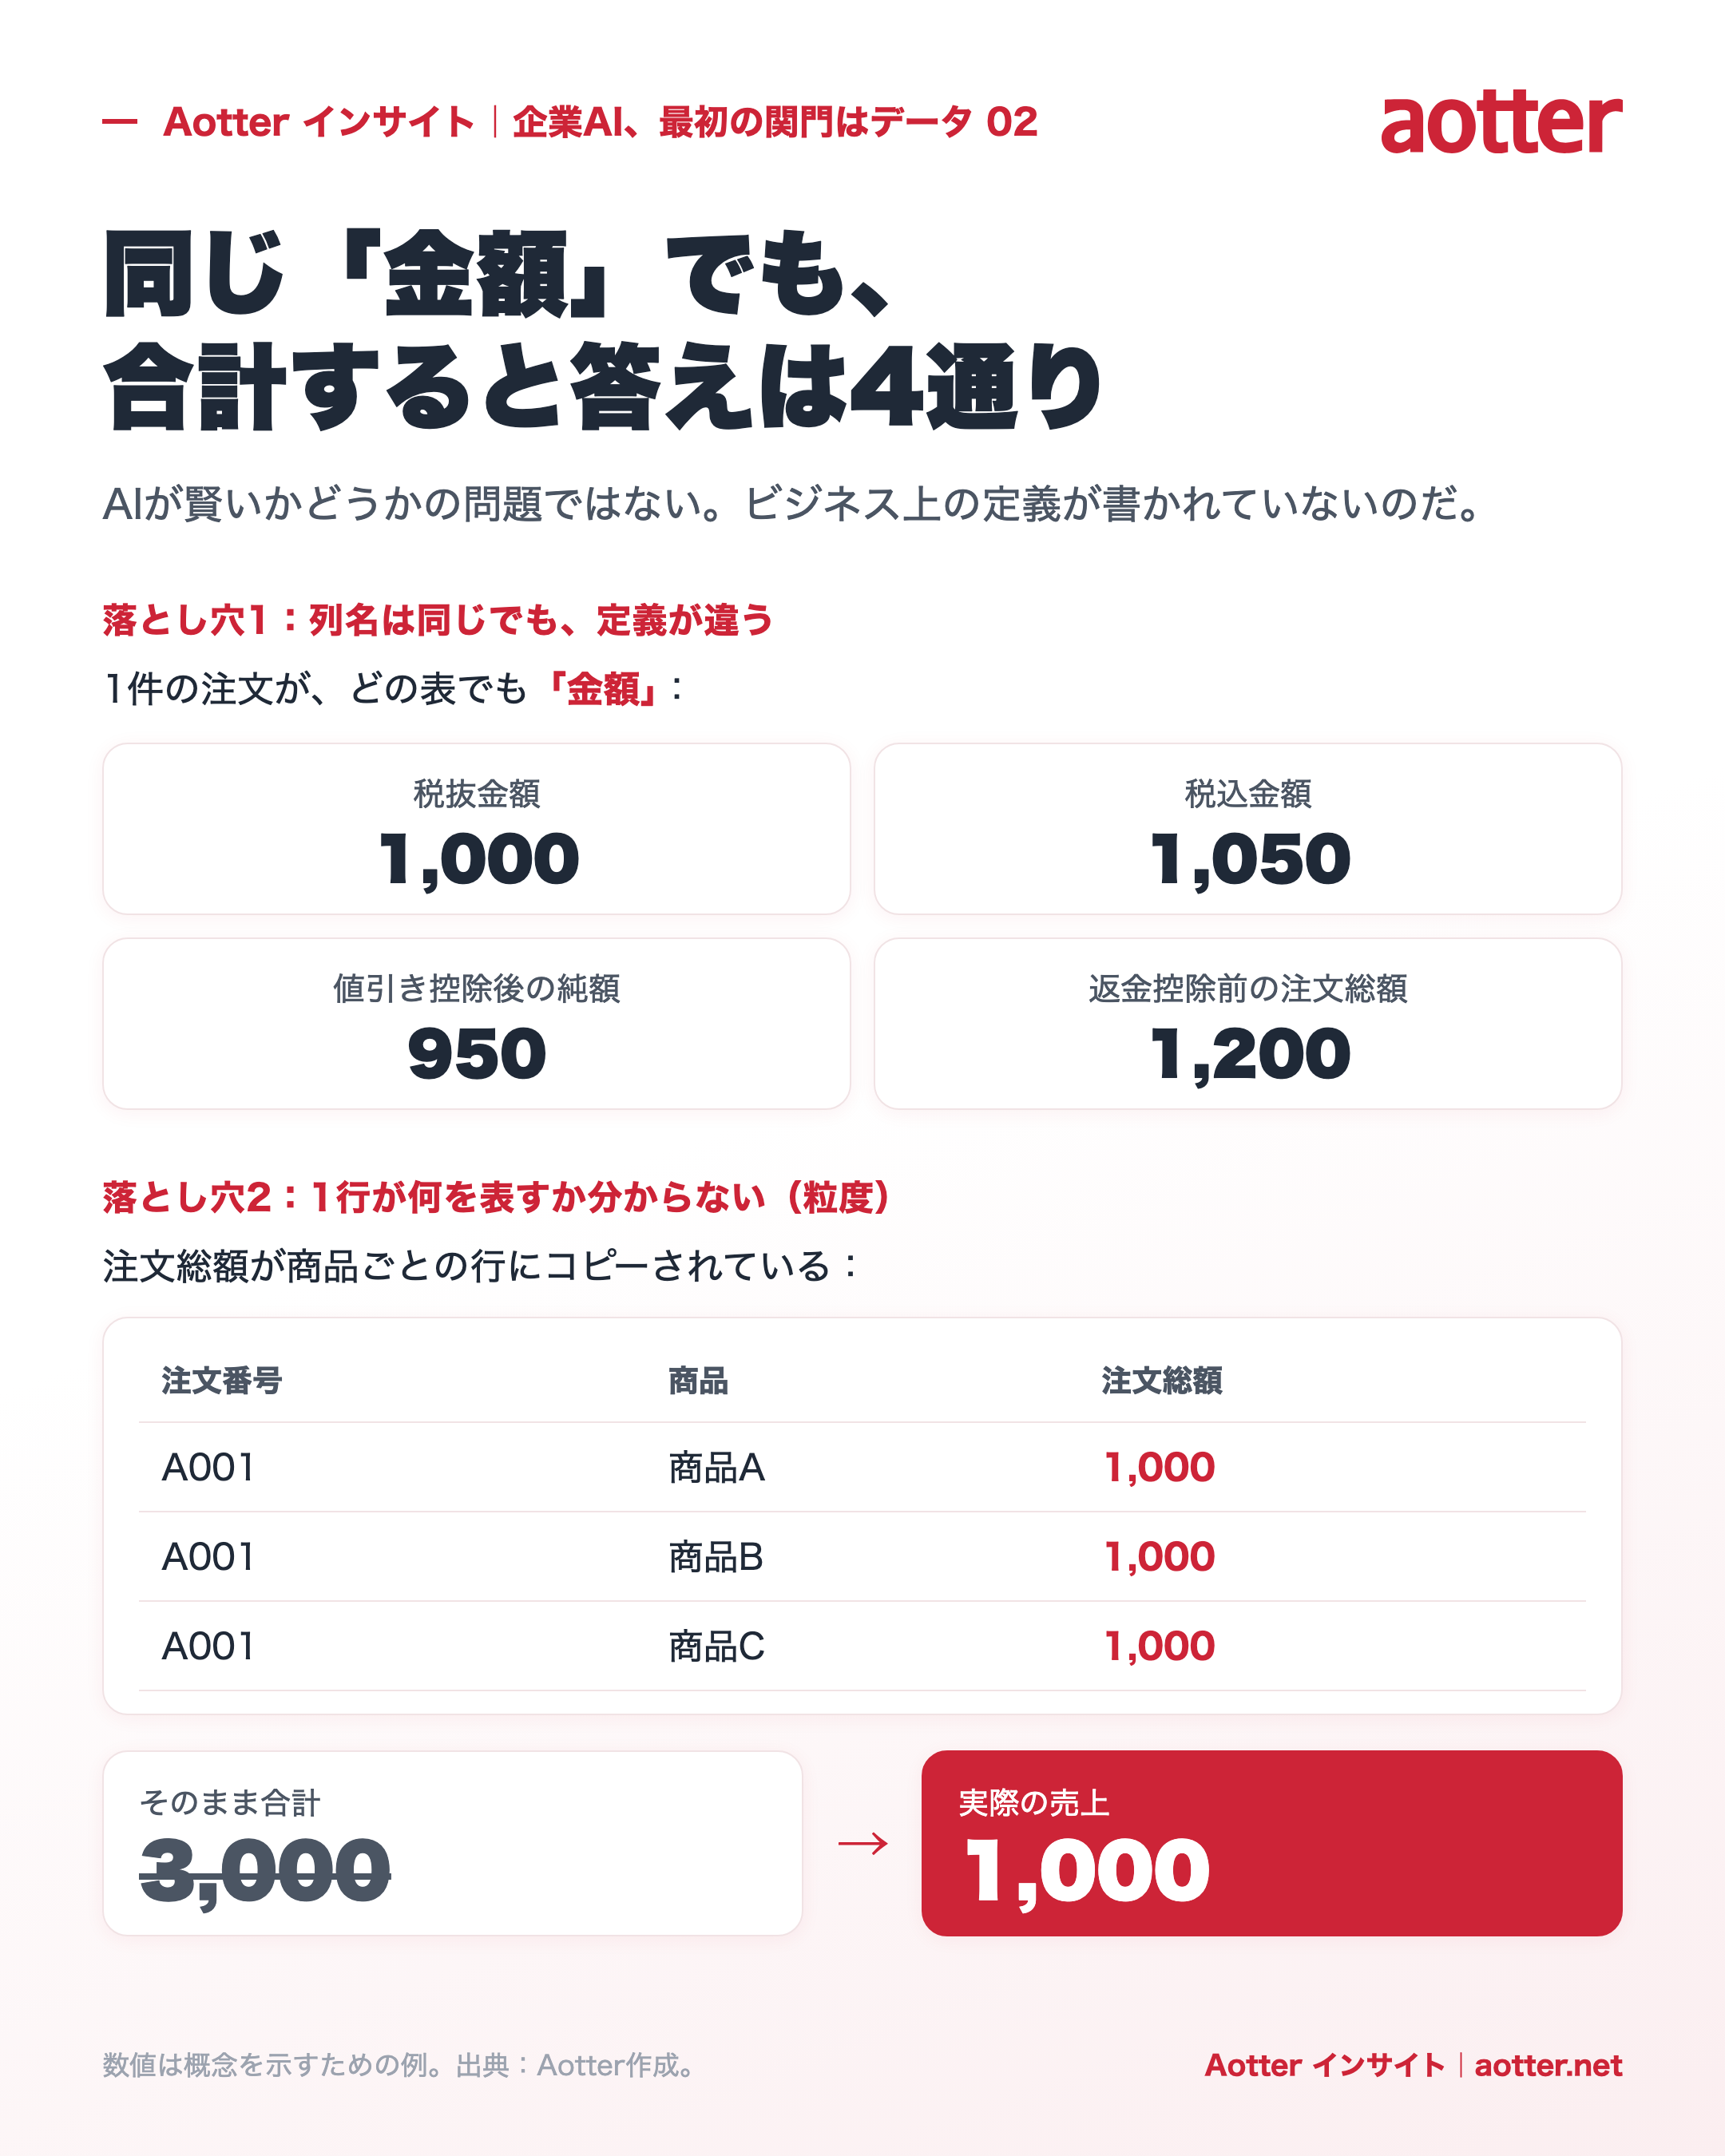
例えば「金額」は税抜金額かもしれず、税込金額かもしれず、値引き後の純額かもしれず、あるいは単に返金前の注文総額かもしれません。表の上ではすべて「金額」と呼ばれていても、足し合わせると全く異なる経営上の結論が得られてしまいます。また例えば、ある行のデータは一つの注文を表すこともあれば、一つの注文の中の一つの商品品目を表すこともあります。システムがデータの粒度を知らなければ、注文総額を各商品行にコピーしてしまい、総売上が簡単に二重計算されてしまいます。これらは AI が賢いかどうかという小さな問題ではなく、ビジネス定義が明確に書かれていないときに、どんなレポートやモデルでもエラーが発生し得る根本原因なのです。
私たちは昨年から多くの Generative BI、data lakehouse、semantic layer のソリューションに触れてきました。これらのツールは企業がデータを照会・分析・表示するのを助けますが、多くの使用シナリオでは通常、データが既に整理され、分析可能なデータベースやデータウェアハウスに格納されていることを前提としています。言い換えれば、これらは「既に準備ができたデータ」を扱うのには非常に長けていますが、必ずしも企業が最初に直面するデータの棚卸し、列のクリーニング、ルールの定義、関連付けの構築、更新スケジューリングといった問題を解決してくれるわけではありません。
これこそ企業によくある導入順序の問題です。皆が急いで AI の問答を見たがる一方で、データをまだ準備できていないのです。現場のデータはシステム、添付ファイル、異なるバージョンのスプレッドシートに散らばっており、導入プロジェクトはまずデータを探し、人に聞き、列を確認し、それから同じ分析可能な環境に入れる方法を考えなければなりません。従来のやり方では、多くの場合コンサルタントとシステムインテグレーションチームが案件ごとに棚卸しを行い、数週間、あるいはそれ以上の時間をかけて、ようやく最初のバージョンの分析可能なデータウェアハウスを構築できるかもしれません。これはコンサルタントや SI に価値がないという意味ではなく、企業がしばしば時間のかかるデータエンジニアリングの工程を先に完了させなければ、AI がビジネスのために何ができるかを議論し始められないということを意味しています。
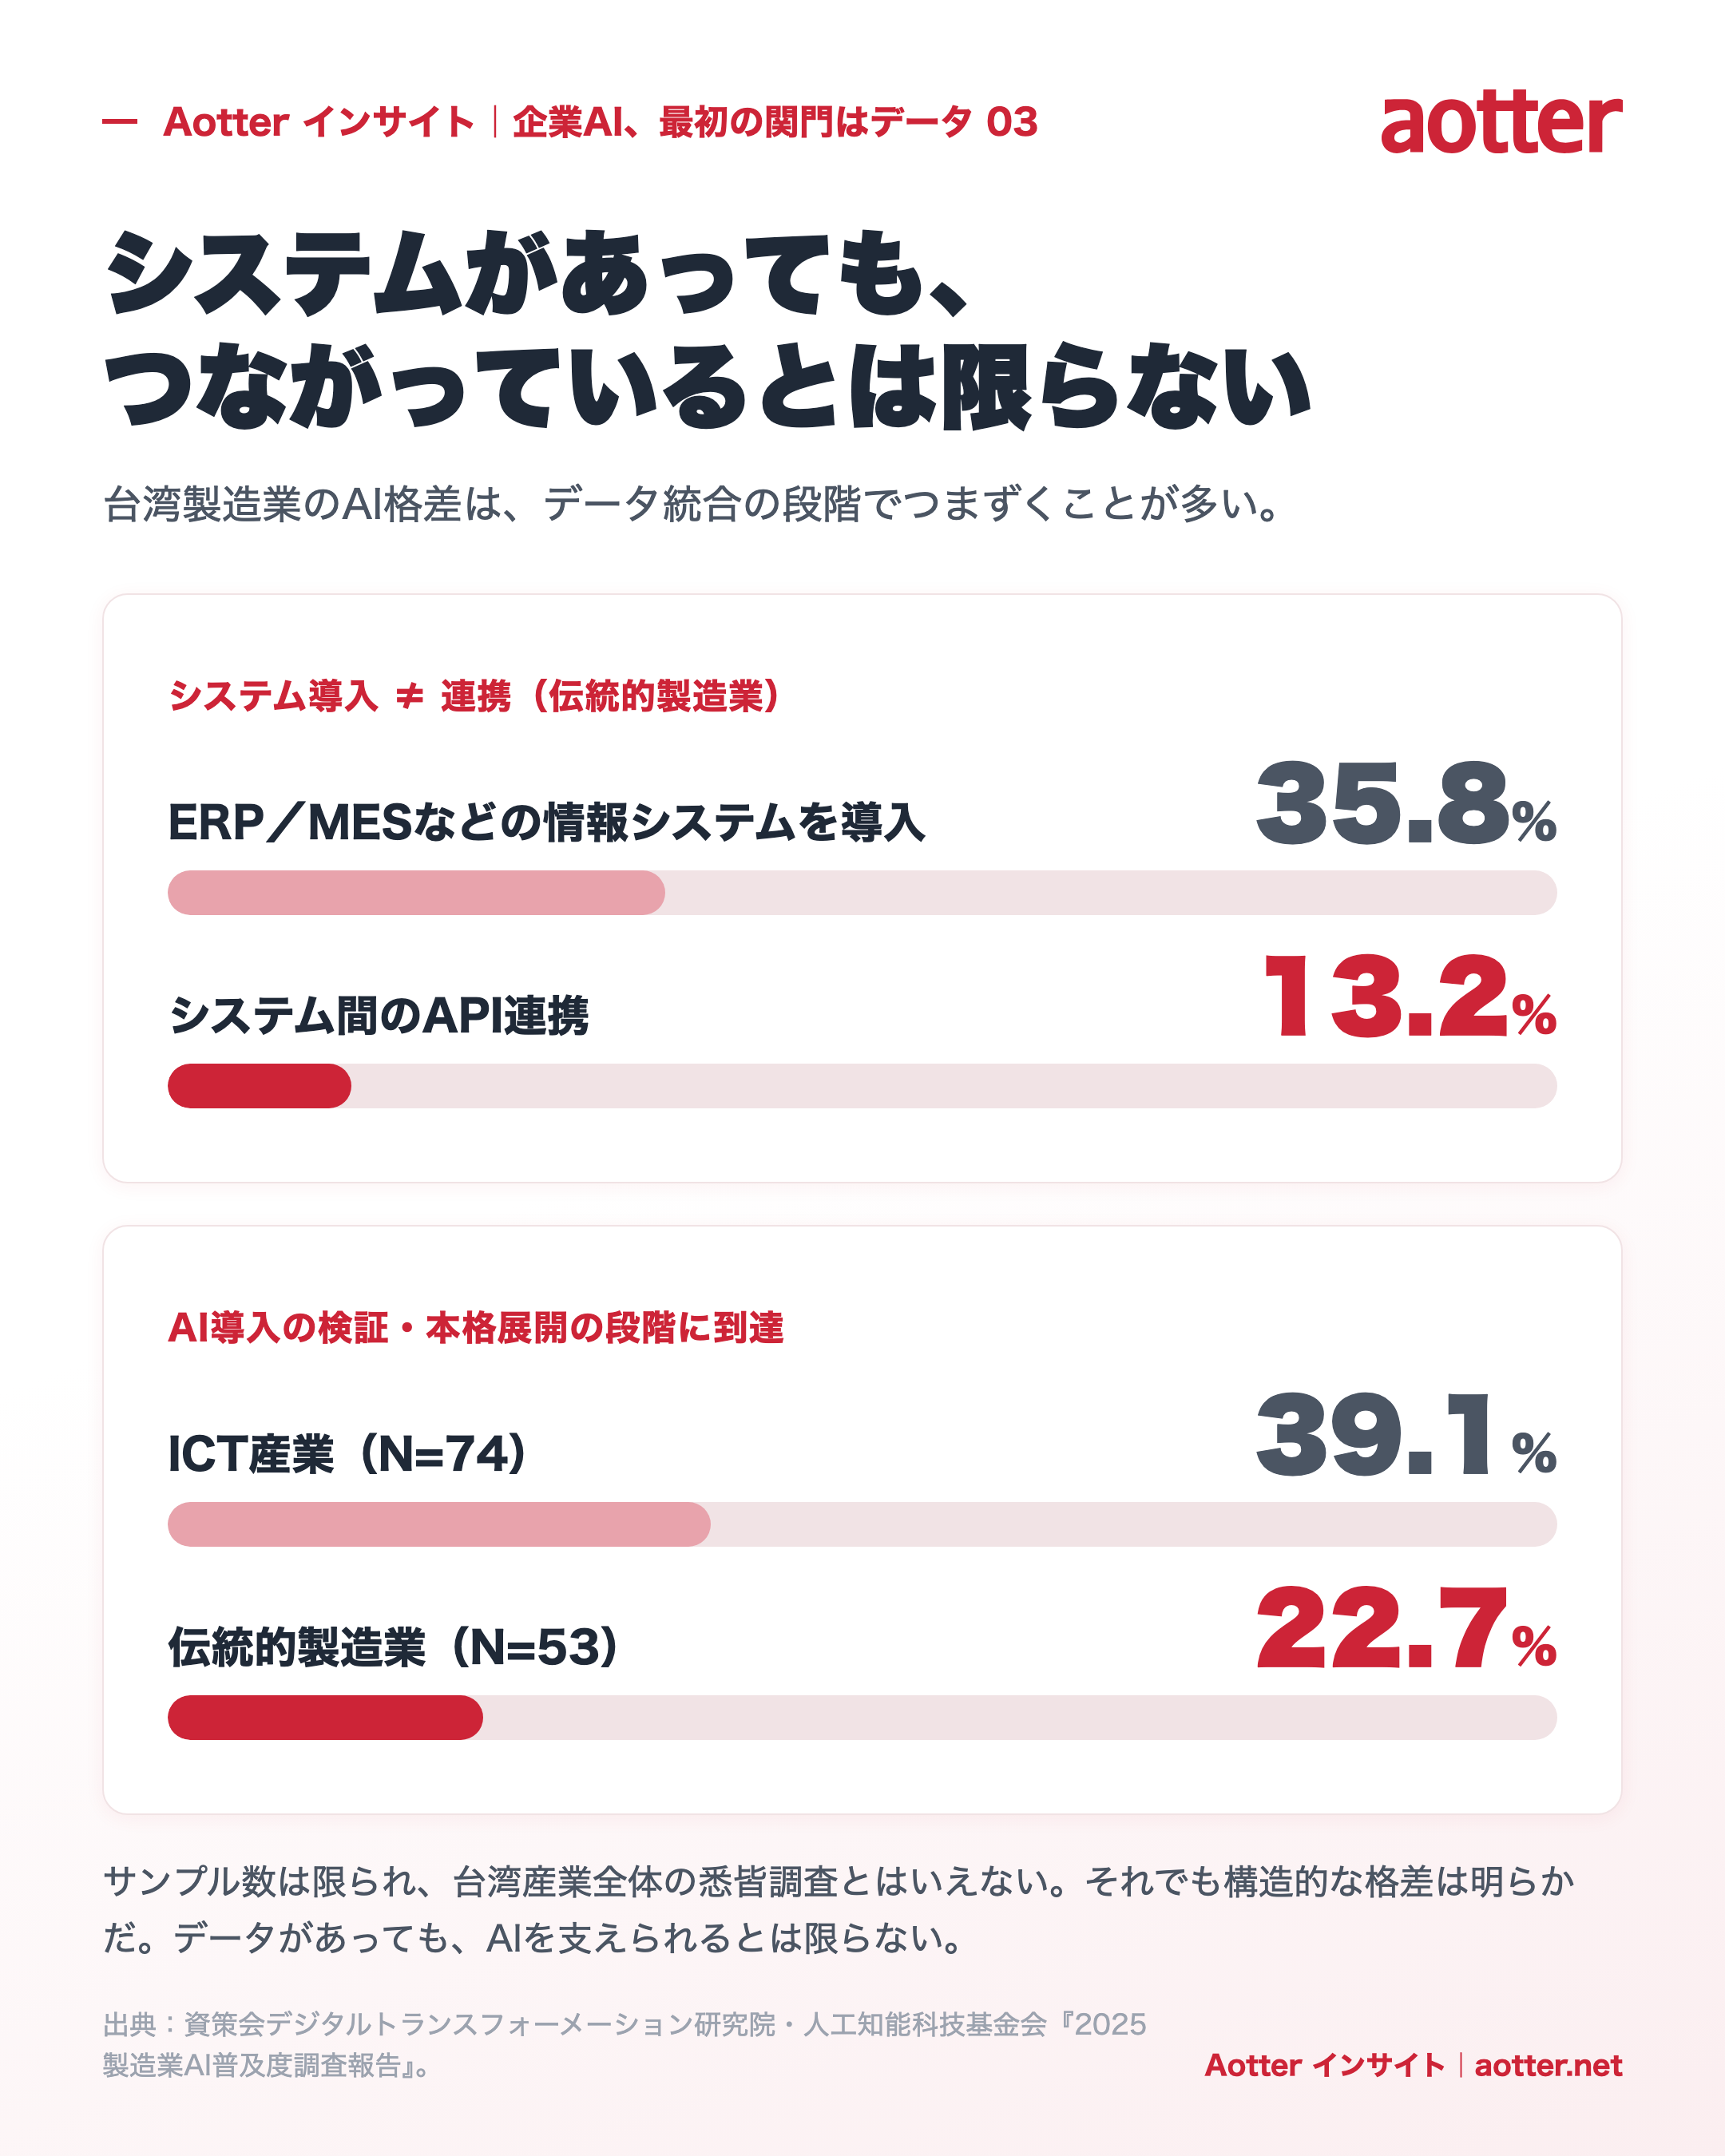
台湾のローカル調査も、この問題をより具体的にしています。資策會デジタルトランスフォーメーション研究院と人工知能科技基金会による 2025 年製造業 AI 普及度調査は、従来型製造業と ICT 産業を分けて観察しています。報告によると、従来型製造業の回答サンプルのうち、35.8% が ERP や MES などの情報システムを導入し、システム間 API 統合比率は 13.2%。従来型製造業が AI 導入の検証段階や規模化段階に進んでいる比率は 22.7% で、ICT 産業の 39.1% よりも低くなっています。この研究のサンプル規模は限られており、グループごとのサンプルはそれぞれ従来型製造業 53 社と ICT 産業 74 社であるため、台湾産業全体の精確な全数調査結果として直接推論すべきではありません。しかし、これは構造的な格差を非常に明確に示しています。システムがあることは、システム同士が通じ合うことを意味しません。データがあることも、データが既に AI を支えられることを意味しません。4
企業が私たちにデータクリーニングについて相談しに来るとき、よく聞く答えは「まず人を見つけてデータを抽出し、ETL を行い、整理してから倉庫に入れる」というものです。ETL とはデータの抽出、変換、ロードのプロセスを指し、本来からデータエンジニアリングの重要な仕事です。しかし、すべての種類のレポートに対して毎回一から処理プログラムをカスタマイズする必要があり、データ形式が変わるたびに修正が必要で、後任者も過去のルールを再度理解しなければならないとなると、導入コストはなかなか下がりません。企業が必要としているのは、データクリーニングが簡単であるかのように装うことではなく、大量の繰り返しが可能で、記述可能で、検証可能なステップを、再利用可能なルールに整理することです。
そこで私たちは、一見とても単純な質問を自問し始めました。Excel の形式は千変万化ですが、それでも明確に記述できる安定したデータ処理の「原子」が存在するのではないか?ある表をどう読むべきか、どの行を除外すべきか、列をどの型に変換すべきか、どうやって一件のレコードを判断するか、どうやって別の表と関連を構築するか、そして新しいファイルが入ってきたらどう更新するか。これらの作業はもちろん AI を加えただけで自然にリスクがゼロになるわけではありませんが、定義、ルール、検証、実行に分解することができ、毎回「以前はだいたいこうやっていた」と記憶している特定の同僚に頼るだけではなくなります。
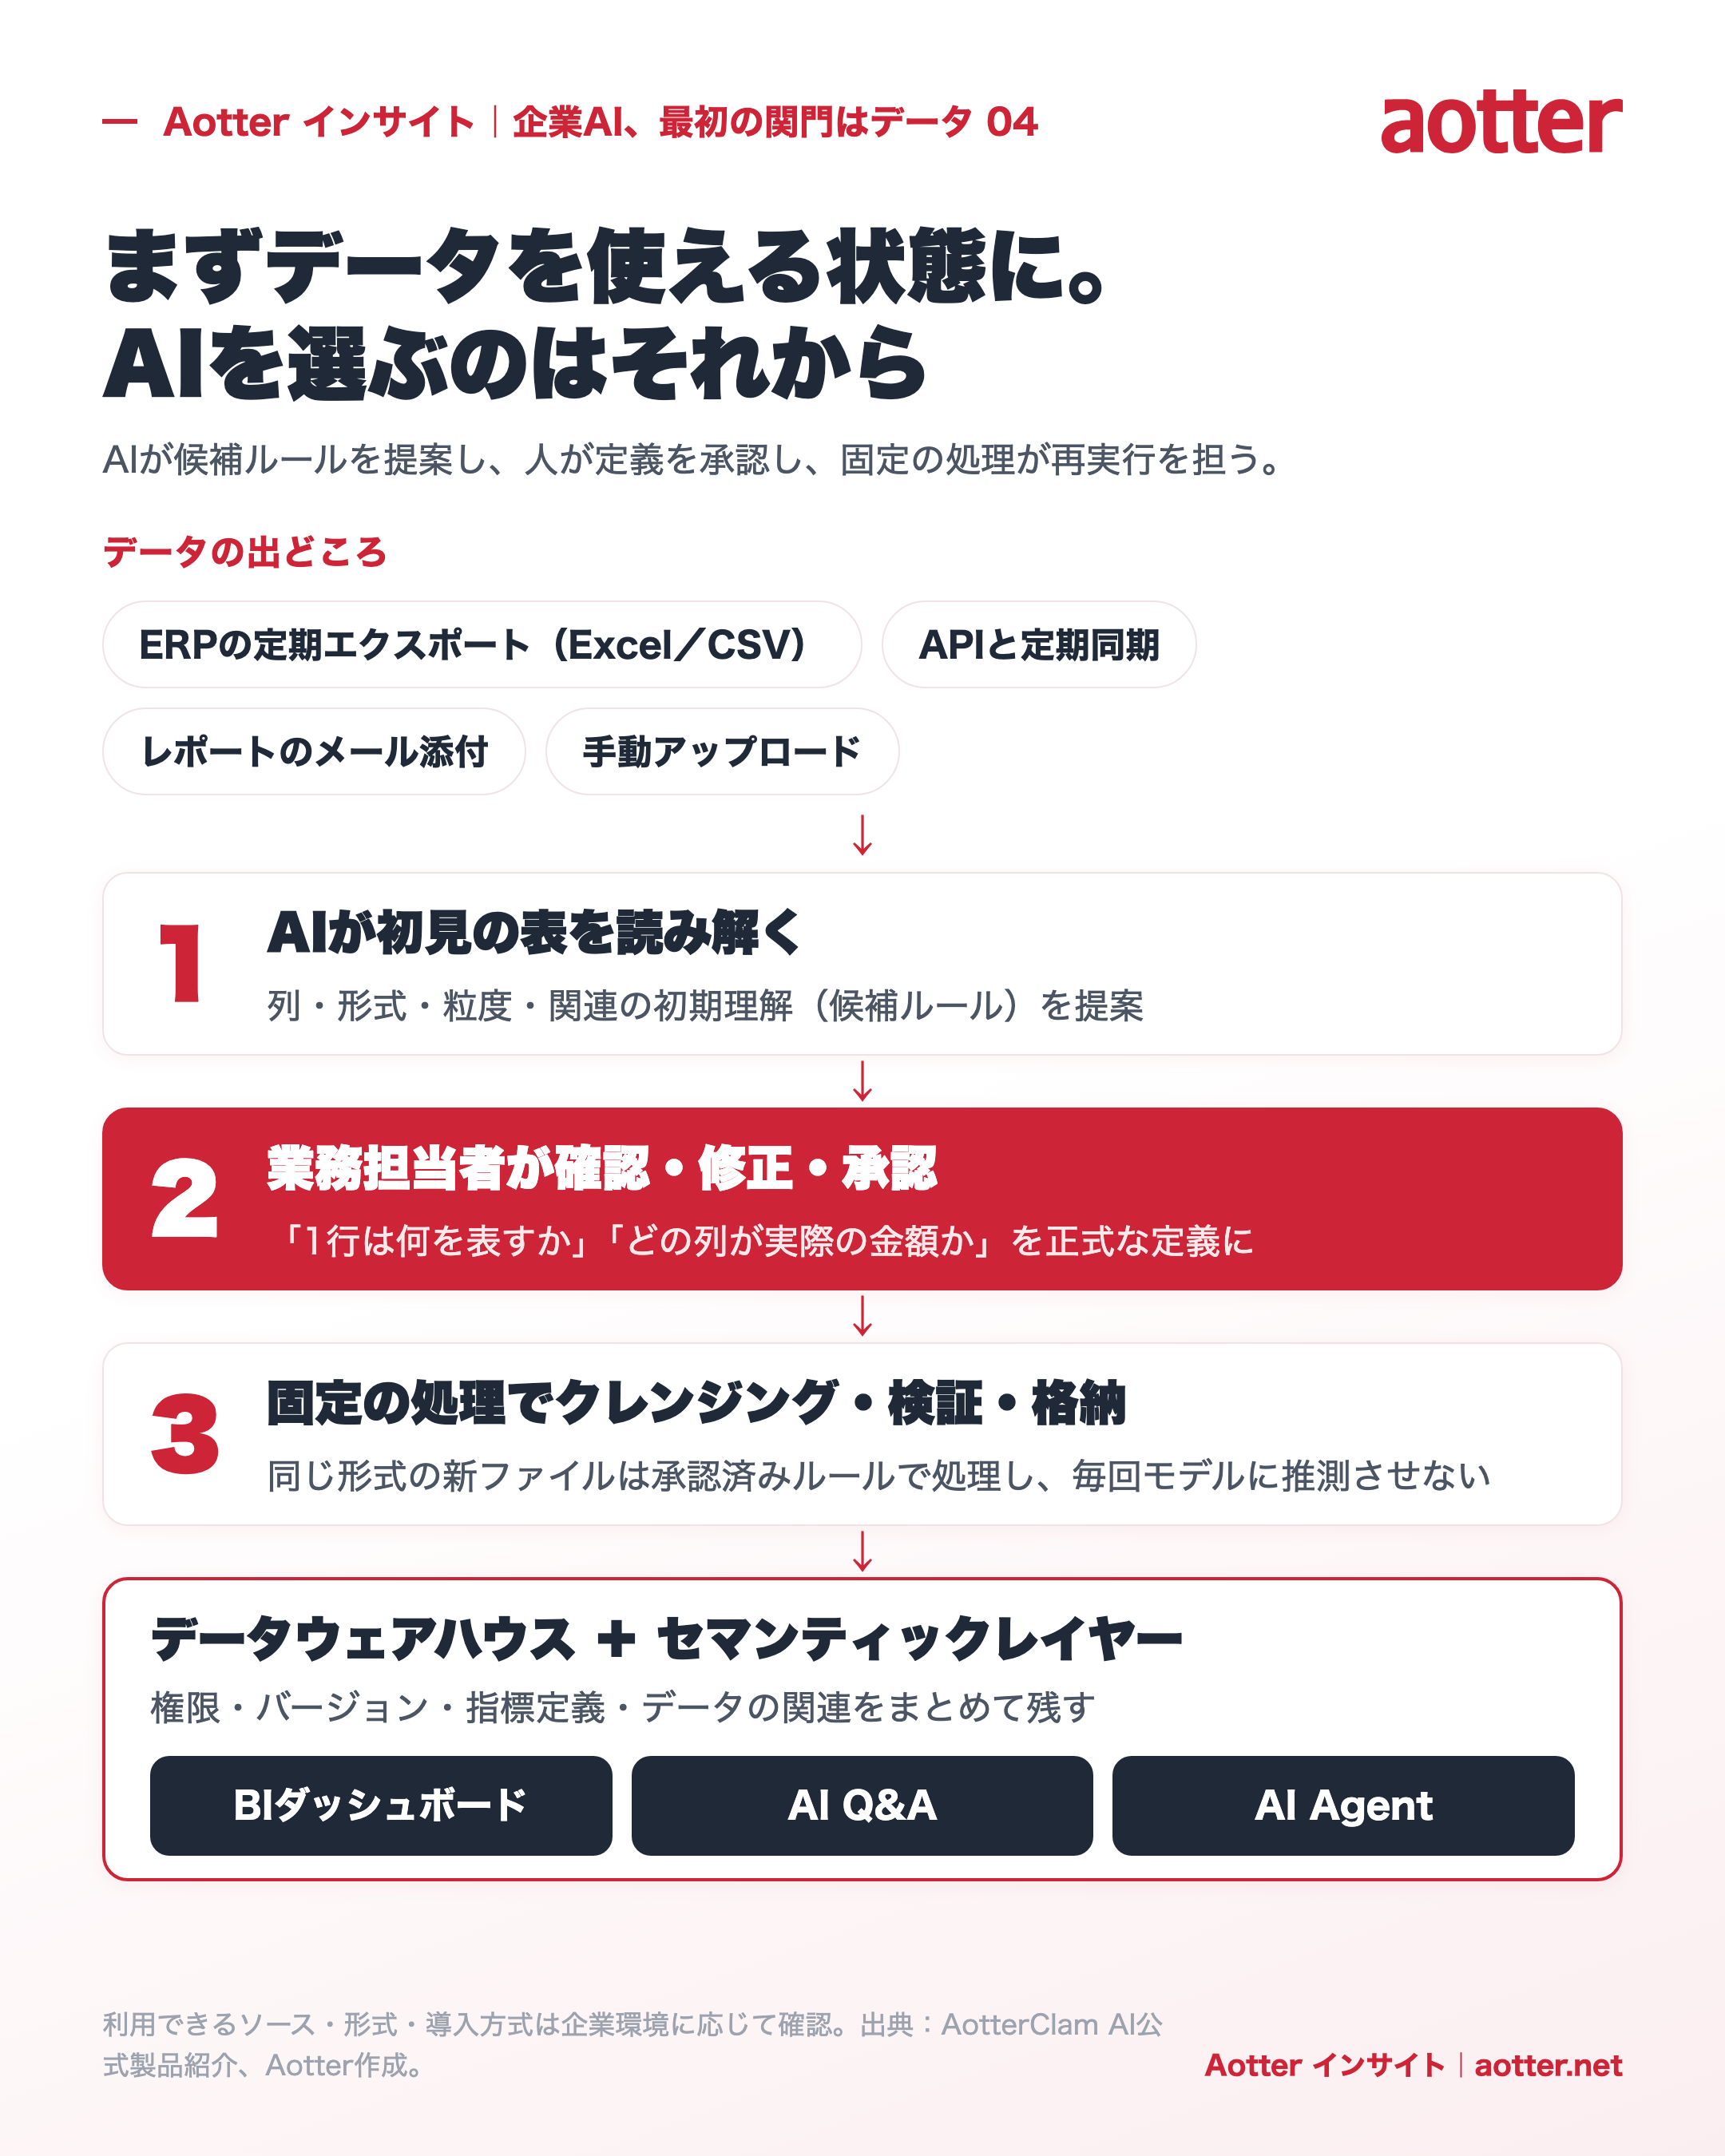
数ヶ月の研究を経て、私たちはデータサイエンスとデータエンジニアリングで繰り返し現れる処理方法を、一セットの宣言的な文法に整理しました。いわゆる宣言的とは、目標とルールを明確に書き出すことです。例えば「この列は注文日を表す」「小計行は明細に入れない」「注文番号と品目番号で一件のデータを識別する」「金額は値引き後の純額で計算する」といったように、毎回引き継ぎにくい手作業のプロセスだけを残すのではありません。AI はまず見たことのない Excel を分析し、列、形式、関連についての初歩的な理解を提示できます。続いてビジネスに精通した人がチェックと修正を行い、承認された定義を保存し、固定されたプロセスに渡して以降のファイルを処理させます。
データの取り込みも、同僚の手作業アップロードだけに頼る必要はありません。企業が既存の ERP で定期的にレポートをエクスポートできるなら、既存のスケジュールに沿って Excel や CSV を送ることを継続できますし、システムに API があれば直接接続することもできます。エクスポートファイルが到着した後、システムは承認された定義に従ってクリーニング、検証、更新、倉庫への取り込みを行います。AotterClam AI の公式プロダクト説明を例にとると、現在 Excel と CSV ファイルのインポート、API とスケジュール同期、そしてレポートメールの添付ファイルを自動処理する方式などが挙げられています。実際に利用可能なソース、形式、デプロイ方式は、企業の環境に応じてケースごとに確認する必要があります。5
この設計思想のポイントは、AI に永遠に人間の判断を代替させることではなく、AI が最も得意とする作業を「未整理のデータを理解し、候補ルールを提示する」という位置に置くことです。ビジネス側の確認は「列と指標の意味を判断する」という位置に置き、固定ルールは再現可能なデータフローに実行させます。こうすることで、データエンジニアリングは毎回のインポートのたびにモデルを再び呼び出し、再び推測する必要がなく安定性を失うこともなく、ビジネス担当者も毎回の照会時に表全体の背景を再度説明する必要がなくなります。
 AIアドバイザリー · Powered by MCP
もっと深く知りたい?「AOTTERSMAN」をあなたのAIアドバイザーに
この記事の詳細な推論と実践チェックリストは、AOTTERSMANナレッジベースに収録されています。MCPを導入すれば、お使いのAIアシスタント(Claude / Cursor / Gemini…)がAOTTERSMANの思考フレームワークを直接活用——常時オンラインのAIアドバイザーがもう一人増えるイメージです。
データ主権はあなたの手に
モデルは社内に配置され、データがネットワークの外に出ることはありません。安心してAIを導入できます。