企業がAIを導入する際、最初の壁はモデルではなく、Excelに散らばったデータである
企業のAI導入について話すとき、多くの人はまずどのモデルを選ぶかを尋ねがちです。しかしここ数年、企業とやり取りする中でよく見かける最初の実際的な問題は、「会社のデータは一体どこにあるのか?それが何を意味するのか誰が知っているのか?」ということです。
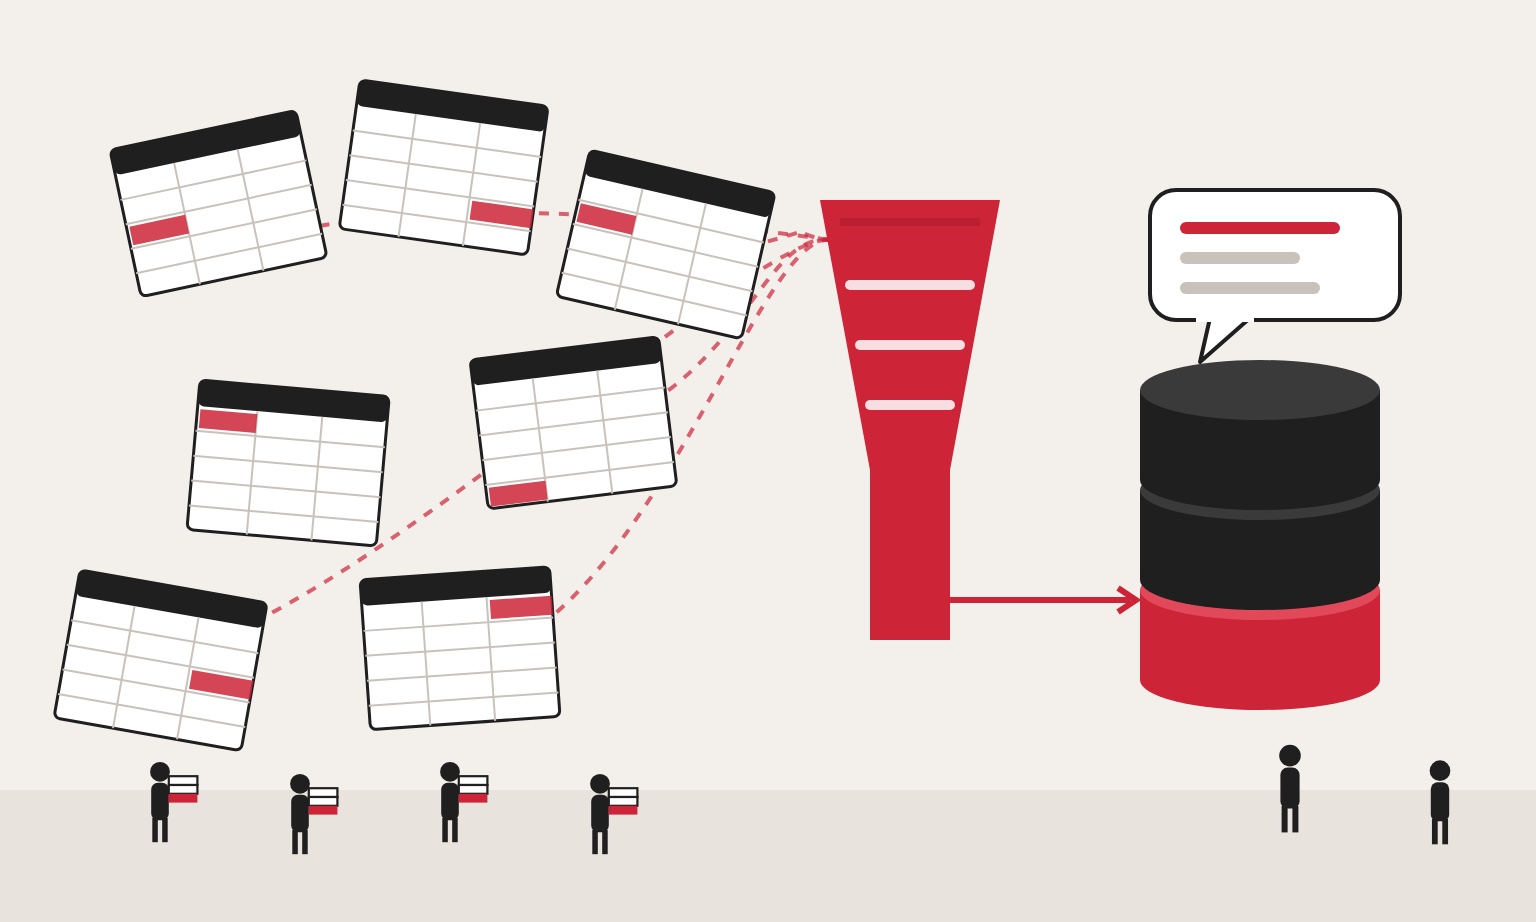
企業の AI 導入について語るとき、多くの人は「どのモデルを選ぶべきか?ChatGPT を使うべきか、Claude か、それとも自前で構築するか?」とすぐに尋ねがちです。しかし、ここ数年企業とやり取りしてきた中でよく見かける最初の実際的な問題は、モデルのランキングではなく、もっと基本的で、かつ見落とされがちなことです。つまり、会社のデータは一体どこにあるのか?誰がそれが何を意味するのか知っているのか?信頼できる形で整理し、異なる部門や異なるツールで繰り返し利用できるようにできるのか、ということです。
多くの企業はデータが無いわけではありません。むしろ逆で、データは多すぎるほどあり、各部門がそれぞれ独自のバージョンを持っています。ERP には一つ、POS には一つ、EC のバックエンドにも一つ、営業担当が送ってくる Excel もまた別のもの。人事、カスタマーサービス、在庫、会計もそれぞれ使い慣れたワークシートを管理しています。普段レポートを作成する必要があるとき、まずファイルを揃え、手作業で列を整理し、小計行を削除し、コードを照合し、日付形式を確認してから、やっと本当のビジネス上の質問に答え始めます。データは既に存在しているのに、それを機械が理解でき、同僚も信頼できる形に「翻訳」するために、大量の人手をまず費やさなければならないのです。
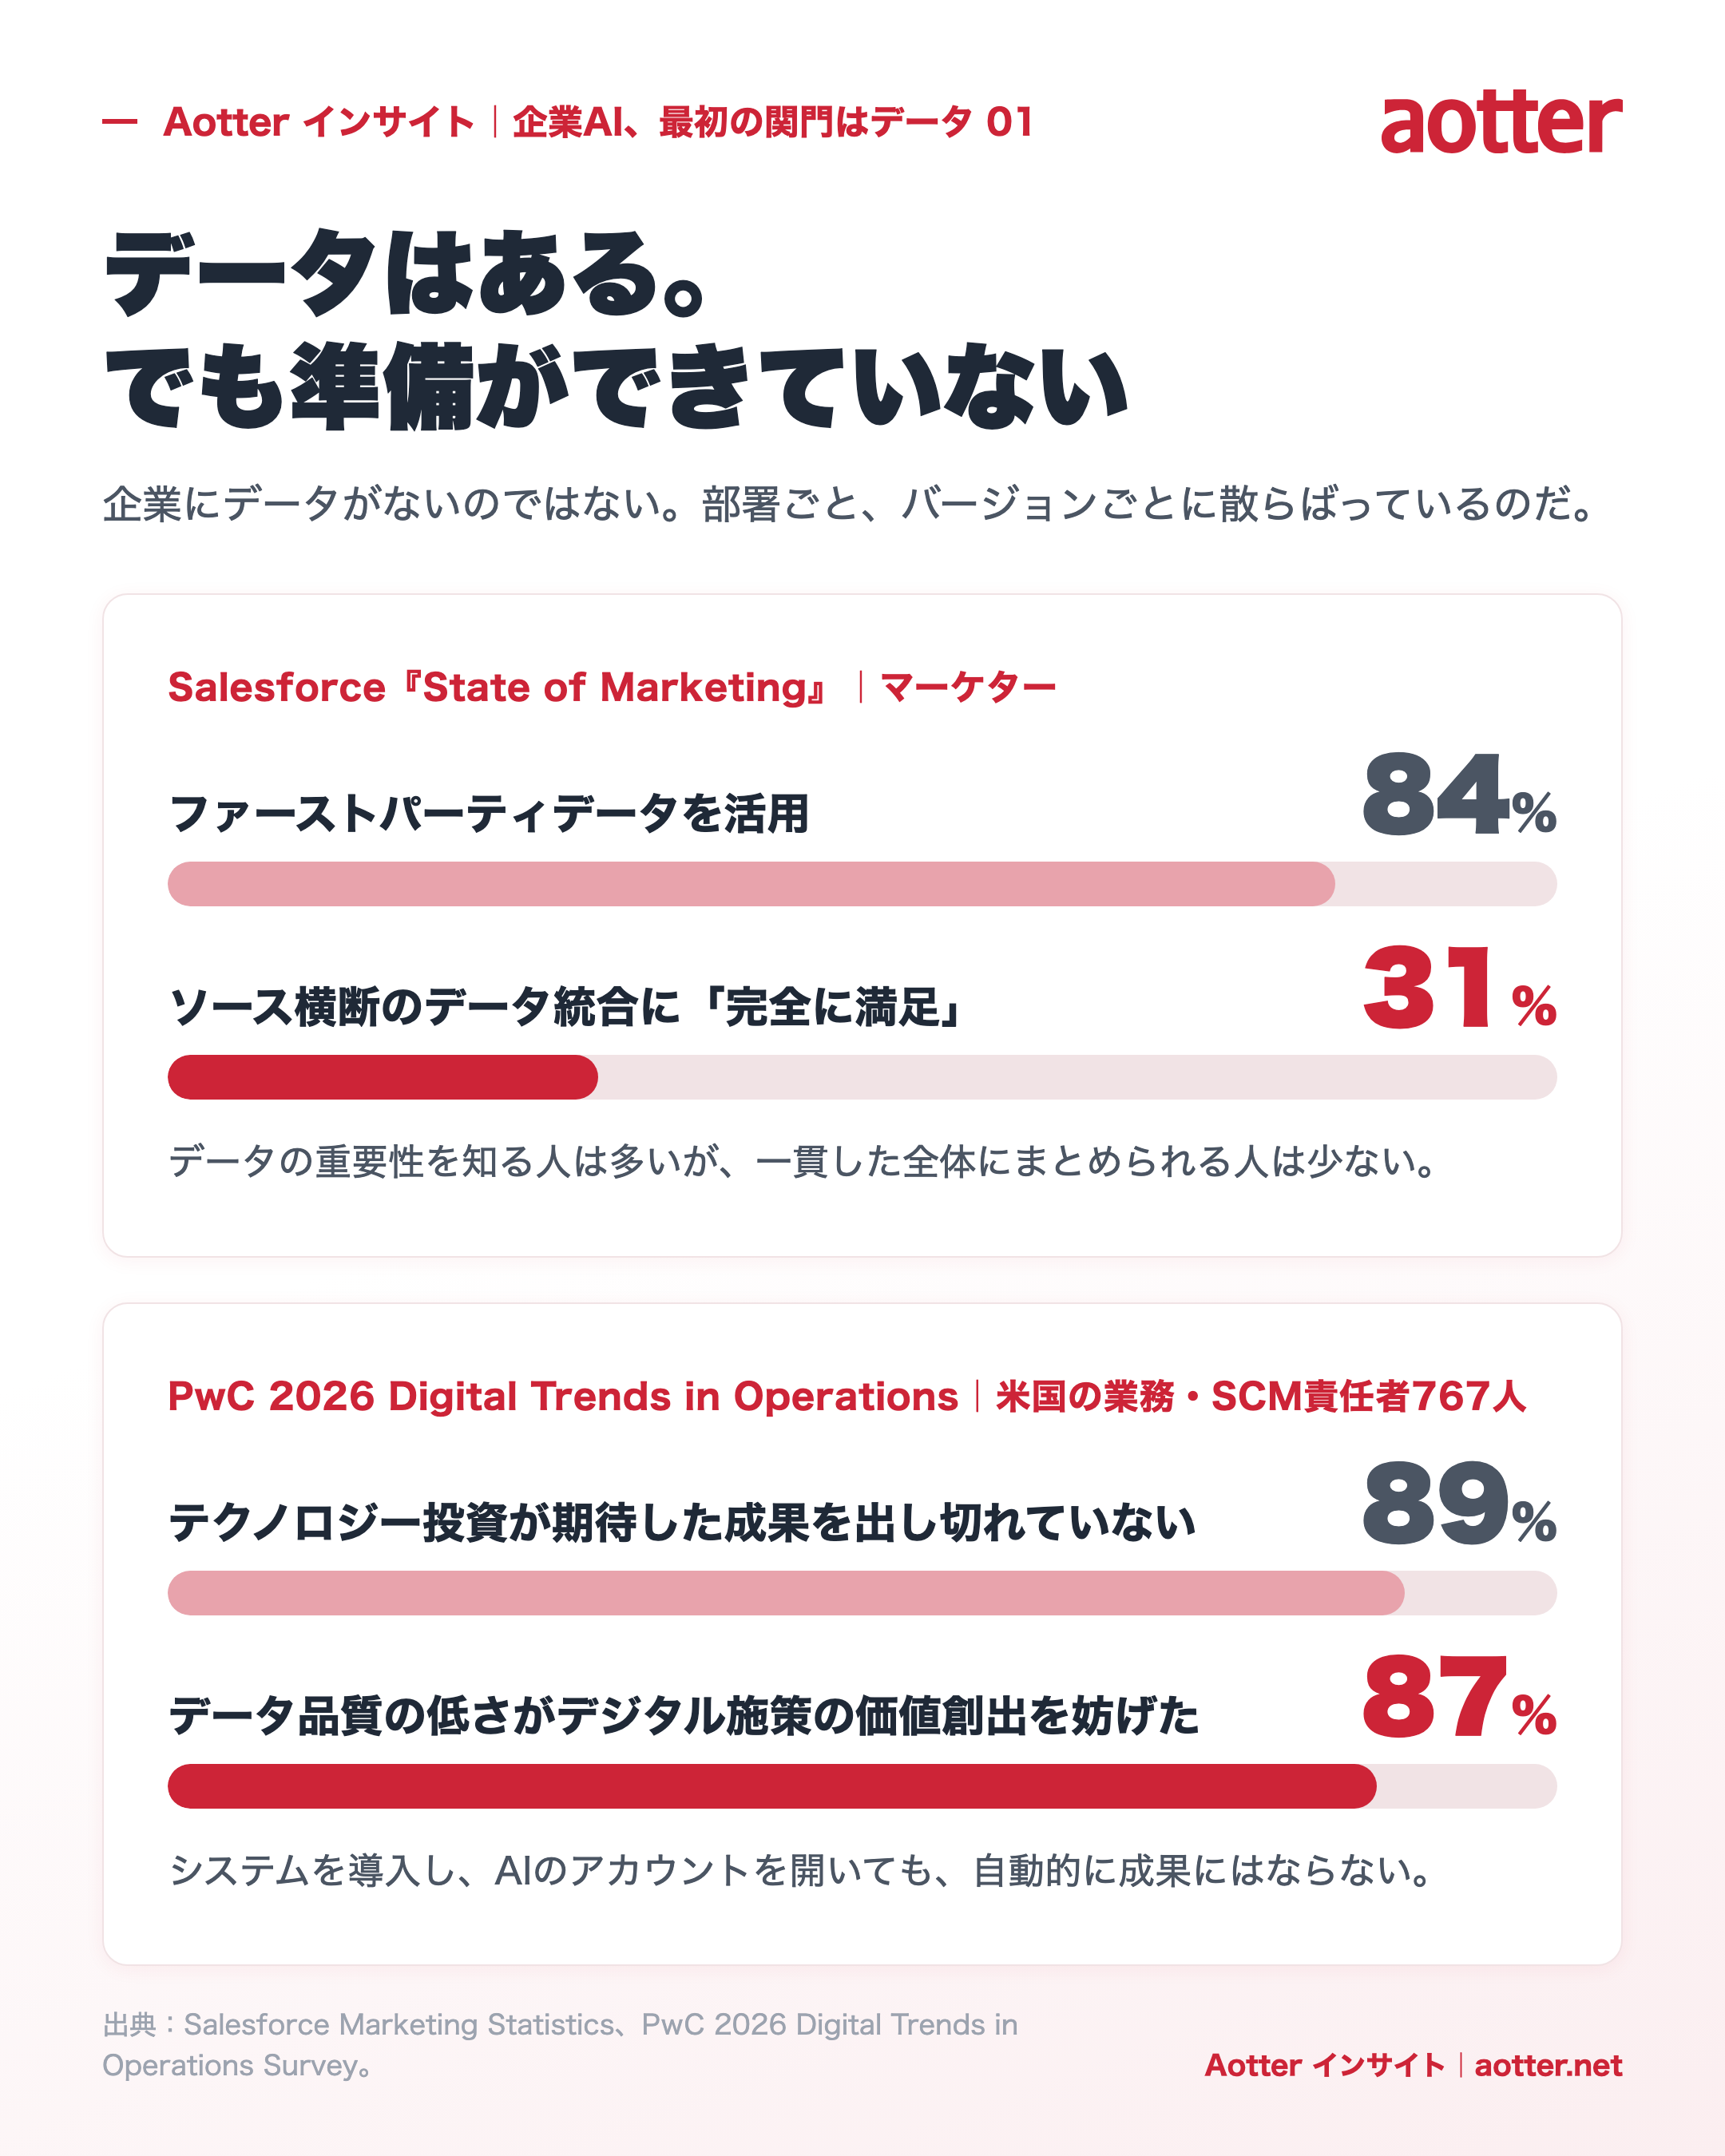
このギャップは、私たちが顧客の現場で目にした個別の事例にとどまりません。Salesforce の《State of Marketing》関連の統計によると、84% の回答したマーケティング担当者がファーストパーティデータを使用している一方、クロスソースのデータ統合能力に完全に満足しているのはわずか 31% にすぎません。この二つの数字を並べて見ると非常に興味深いものがあります。企業は徐々に自社のデータの重要性を認識し始めているものの、依然として多くのチームが各所のデータを一貫性のある、使用可能な全体として整理できていないのです。1
PwC が 2026 年に米国の 767 人の運営・サプライチェーン責任者を対象に行った調査も、同様の現実を示しています。回答者の 89% が、テクノロジーへの投資がまだ当初期待していた成果を完全にはもたらしていないと述べ、87% がデータ品質の低さがデジタル計画の価値創出能力に影響していると指摘しています。これは全ての企業のデータが乱雑であるという意味ではなく、システムを導入し AI のアカウントを開通させても、データ品質、システム連携、ワークフローの処理を同時に行わなければ、投資が自動的に成果に変わるわけではないことを思い出させてくれます。2
そこで、昨年から私たちは一見それほど華やかではないものの、実際には非常に重要な仕事にスキルを投入し始めました。それは、AI が企業のデータの清掃と整理を支援することです。一年経った今、プロダクトは徐々に成熟し、私たちは AotterClam AI をリリースしました。これはもう一つのチャット画面を作ることではなく、古いシステム、レポート、ファイルに散らばったデータを、ガバナンス可能で、更新可能、かつ後続の AI や BI ツールで利用できるデータ基盤に整理することを目指しています。
なぜ皆 AI について語りながら、最終的によく Excel で詰まってしまうのか?
私たち Aotter はデータ関連の仕事を十数年行っており、データエンジニアリングとデータガバナンスの日常業務に精通しています。外部の人が私たちを知るきっかけは、おそらく AotterGirls から始まったでしょう。しかし Aotter は創作ツール、コンテンツプロダクトから、データ広告、ファーストパーティデータの活用、そして企業 AI へと歩んできましたが、その背後では一貫して同じ種類の問題を扱ってきました。つまり、情報が価値に変わる時間をどう短縮するかということです。私たちがメディアと広告テクノロジーの現場で長年ユーザー行動データを扱ってきた中で分かったのは、データを収集することは始まりに過ぎないということです。本当に難しいのは、整理、定義、権限、用途、そして将来も継続して更新できるかどうかです。10 11
ファーストパーティデータの議論は、過去はマーケティングや広告の分野でよく登場していましたが、現在ではますます企業運営の核心に近づいています。それはブランドが直接収集した会員や取引データだけでなく、企業が合法的で合理的なビジネス関係の中で蓄積した注文、在庫、カスタマーサービスのやり取り、サービス記録も含みます。これらのデータを掌握できるかどうかは、企業が自社の運営状況の中で分析能力を構築できるかどうかに関わり、毎回外部プラットフォームが提供する概略的な答えに頼る必要がなくなるかどうかに関わります。
このトレンドも「ファーストパーティ」という三文字を貼り付ければ完成するわけではありません。eMarketer が引用した 2024 年の調査によると、ある B2B マーケティング担当者の調査では、67% がデータのコンプライアンスと正確性を重要な優先事項としており、別のグローバルマーケティング担当者調査では 84% が顧客、ファーストパーティ、取引データを活用してオーディエンスを理解していると答えています。これらの数字は特定の調査対象とその時点での市場状況を反映したものであり、すべての企業が既に成熟したデータガバナンス能力を備えていることを意味するわけではありません。しかし、企業がデータの使用可能性と同時に、使用方法がコンプライアンスに適合しているか、正確であるかを気にかけ始めていることを明確に示しています。3
また私たちは特に指摘しておきたいのですが、ファーストパーティデータは「自分が手に入れたデータなら自由に使って良い」という意味ではありません。データがどこから来たのか、収集時に何を告知したのか、どのような用途での使用が許可されているのか、誰が見られるのか、どれくらい保存するのか、他のソースと連携できるのかなど、すべて明確な規範が必要です。本当に価値のあるファーストパーティデータとは、合法的で透明な関係の中で蓄積され、組織が継続的に管理できるデータ資産であり、名前を変えて過剰な収集や無制限の追跡を続けることではありません。
そして企業 AI の状況に入ると、データのボトルネックは非常に現実的な形で現れます。多くの企業が使用している基幹システムは既に何年も稼働しており、ERP、POS、倉庫や受注システムはそれぞれ独自のデータベースを持っているかもしれませんが、システム間に適切な API がなかったり、API はあっても企業に予算、権限、専任担当者がなくそれを接続できていなかったりします。実務上、現場で最もよく使われる外部出力は今もなお Excel や CSV です。毎週売上表をエクスポートしたり、毎日レポートメールを送ったり、月末に同僚が異なる部門のワークシートを統合したりしています。
データが Excel の形で提供されているからといって、それを価値のないデータとして扱うべきではありません。これらのワークシートはしばしば企業の長年の運営経験を蓄積していますが、ただ表の設計がもともと人に奉仕するためのものであり、データパイプラインのためではなかっただけです。一行目はセルを結合したタイトルかもしれず、二行目にようやく列名が来る。同じ列の中に日付、文字、注記が混在している。一つのワークシートの中に明細、小計、合計、備考が混ざっている。異なる部門が同じ列を異なる名前で呼んだり、同じ名前で異なる概念を表したりすることさえあります。
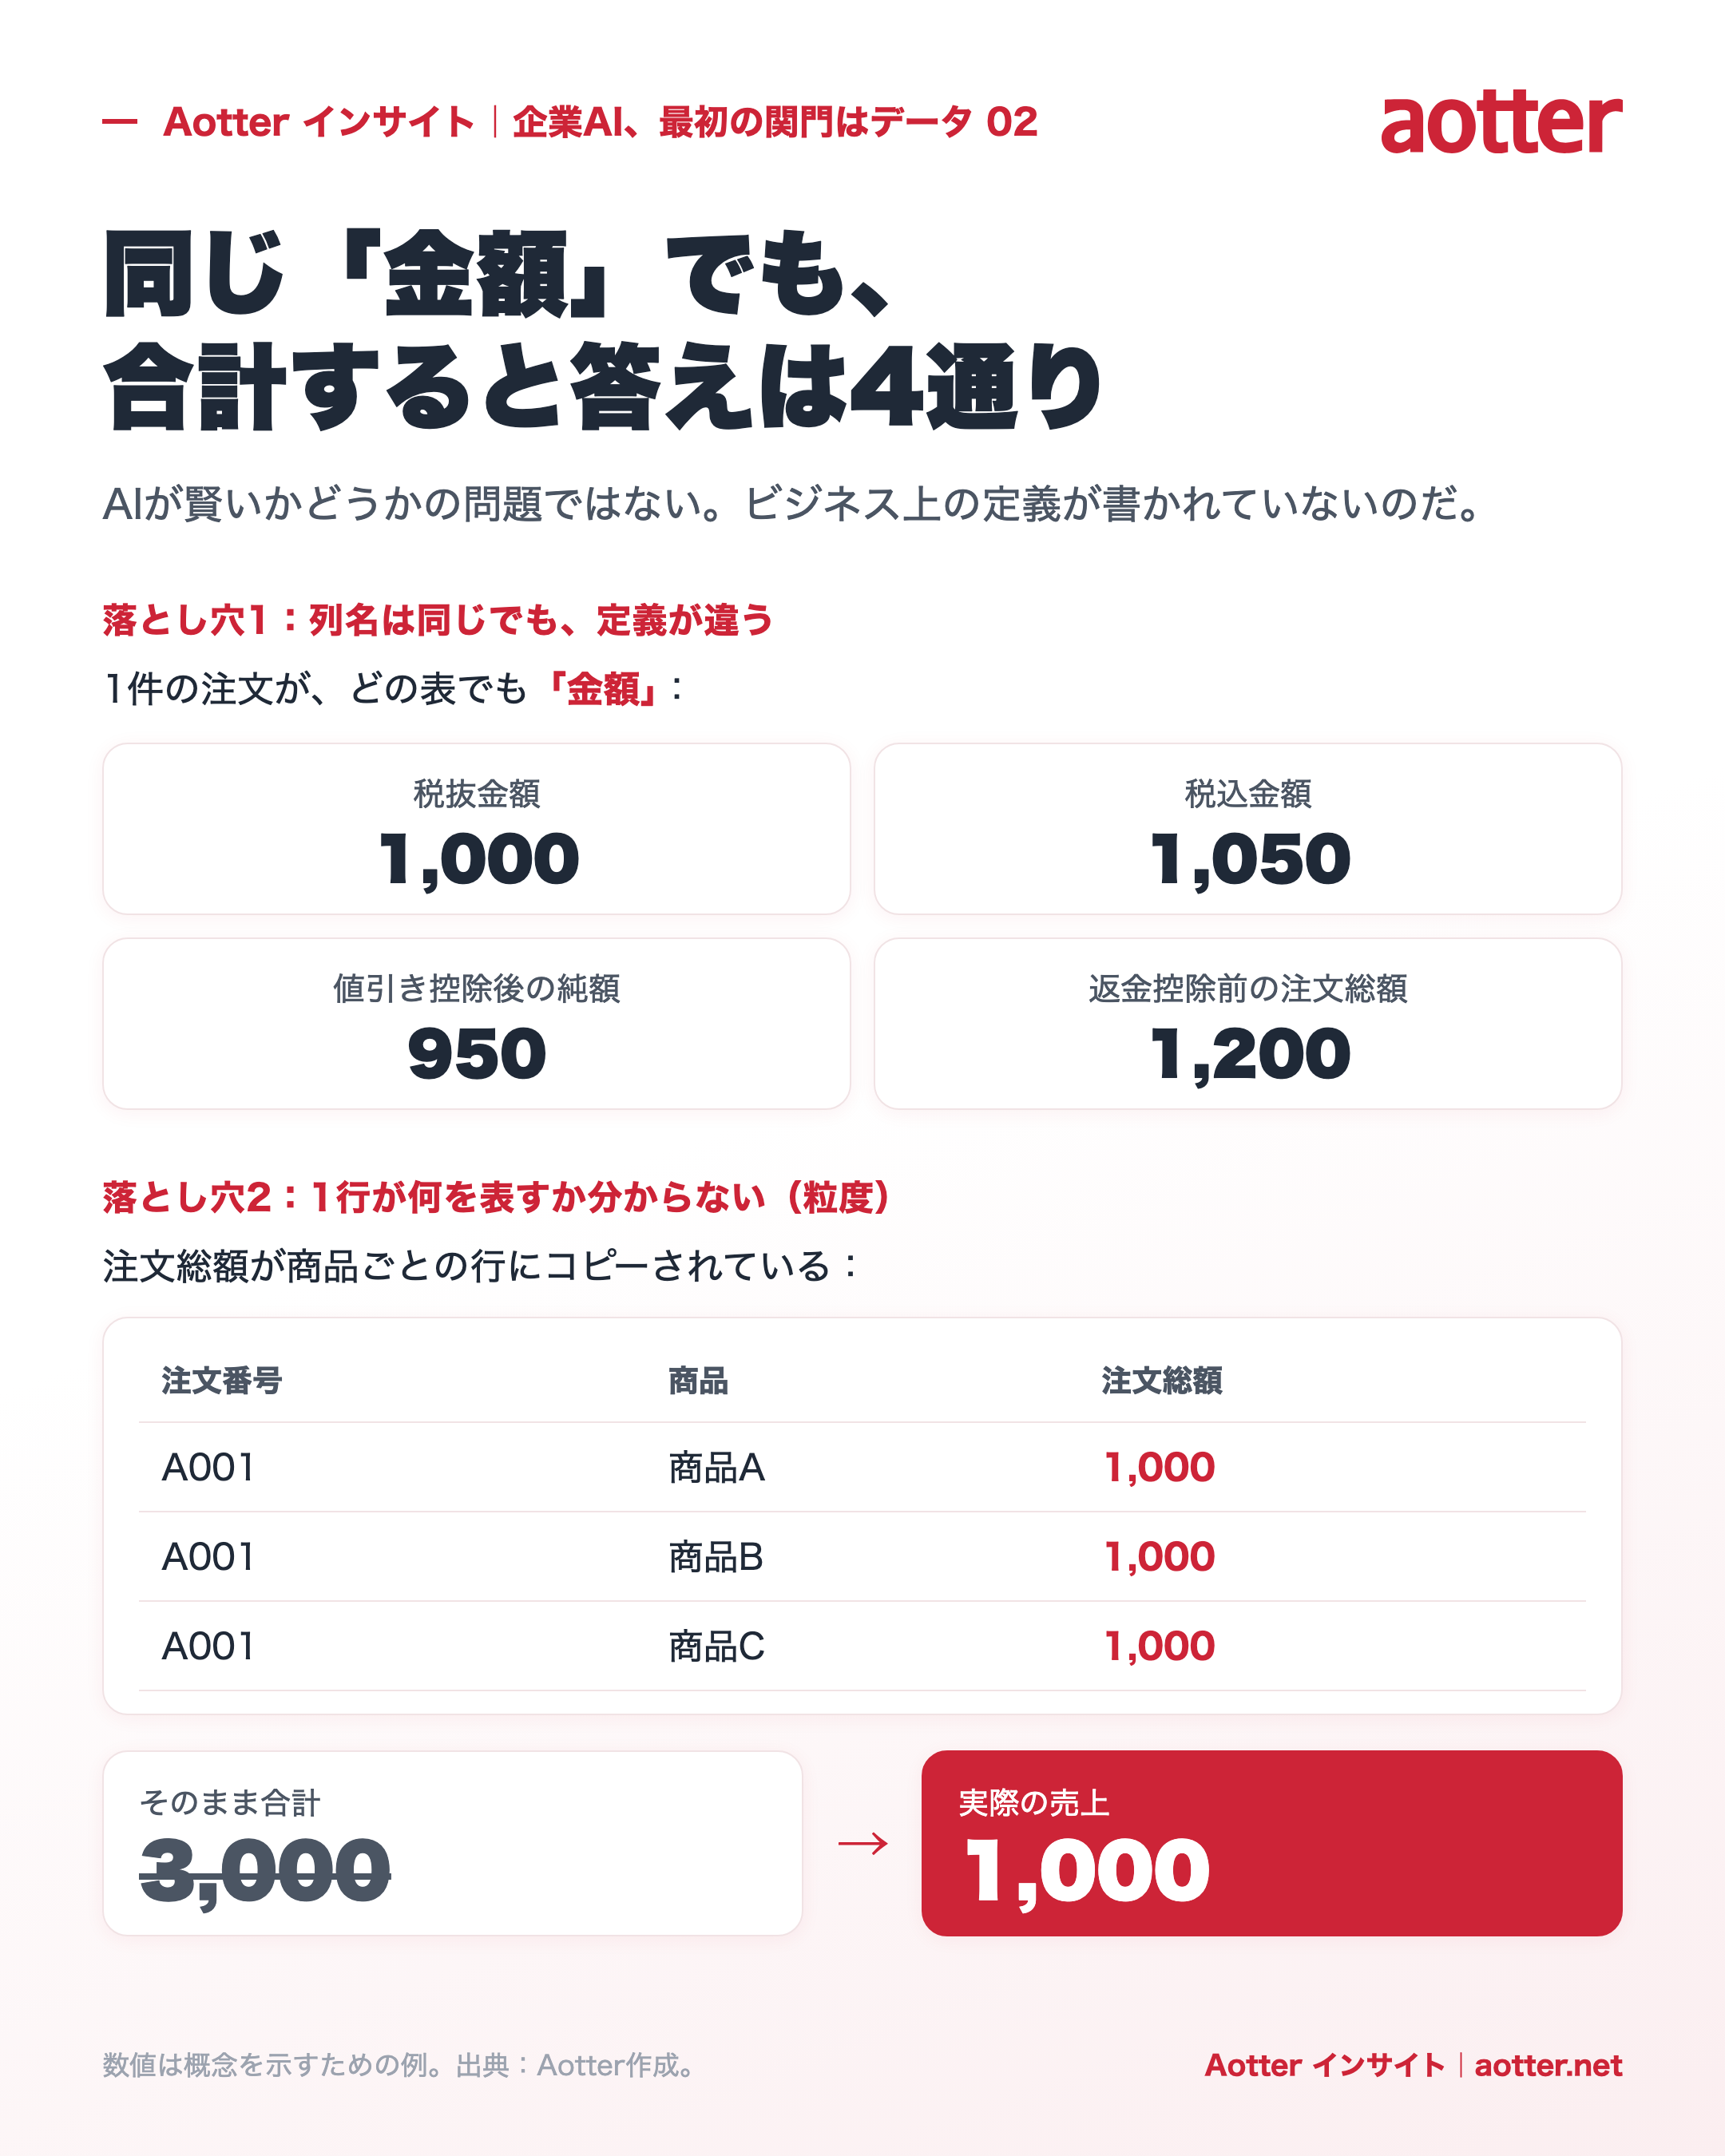
例えば「金額」は税抜金額かもしれず、税込金額かもしれず、値引き後の純額かもしれず、あるいは単に返金前の注文総額かもしれません。表の上ではすべて「金額」と呼ばれていても、足し合わせると全く異なる経営上の結論が得られてしまいます。また例えば、ある行のデータは一つの注文を表すこともあれば、一つの注文の中の一つの商品品目を表すこともあります。システムがデータの粒度を知らなければ、注文総額を各商品行にコピーしてしまい、総売上が簡単に二重計算されてしまいます。これらは AI が賢いかどうかという小さな問題ではなく、ビジネス定義が明確に書かれていないときに、どんなレポートやモデルでもエラーが発生し得る根本原因なのです。
私たちは昨年から多くの Generative BI、data lakehouse、semantic layer のソリューションに触れてきました。これらのツールは企業がデータを照会・分析・表示するのを助けますが、多くの使用シナリオでは通常、データが既に整理され、分析可能なデータベースやデータウェアハウスに格納されていることを前提としています。言い換えれば、これらは「既に準備ができたデータ」を扱うのには非常に長けていますが、必ずしも企業が最初に直面するデータの棚卸し、列のクリーニング、ルールの定義、関連付けの構築、更新スケジューリングといった問題を解決してくれるわけではありません。
これこそ企業によくある導入順序の問題です。皆が急いで AI の問答を見たがる一方で、データをまだ準備できていないのです。現場のデータはシステム、添付ファイル、異なるバージョンのスプレッドシートに散らばっており、導入プロジェクトはまずデータを探し、人に聞き、列を確認し、それから同じ分析可能な環境に入れる方法を考えなければなりません。従来のやり方では、多くの場合コンサルタントとシステムインテグレーションチームが案件ごとに棚卸しを行い、数週間、あるいはそれ以上の時間をかけて、ようやく最初のバージョンの分析可能なデータウェアハウスを構築できるかもしれません。これはコンサルタントや SI に価値がないという意味ではなく、企業がしばしば時間のかかるデータエンジニアリングの工程を先に完了させなければ、AI がビジネスのために何ができるかを議論し始められないということを意味しています。
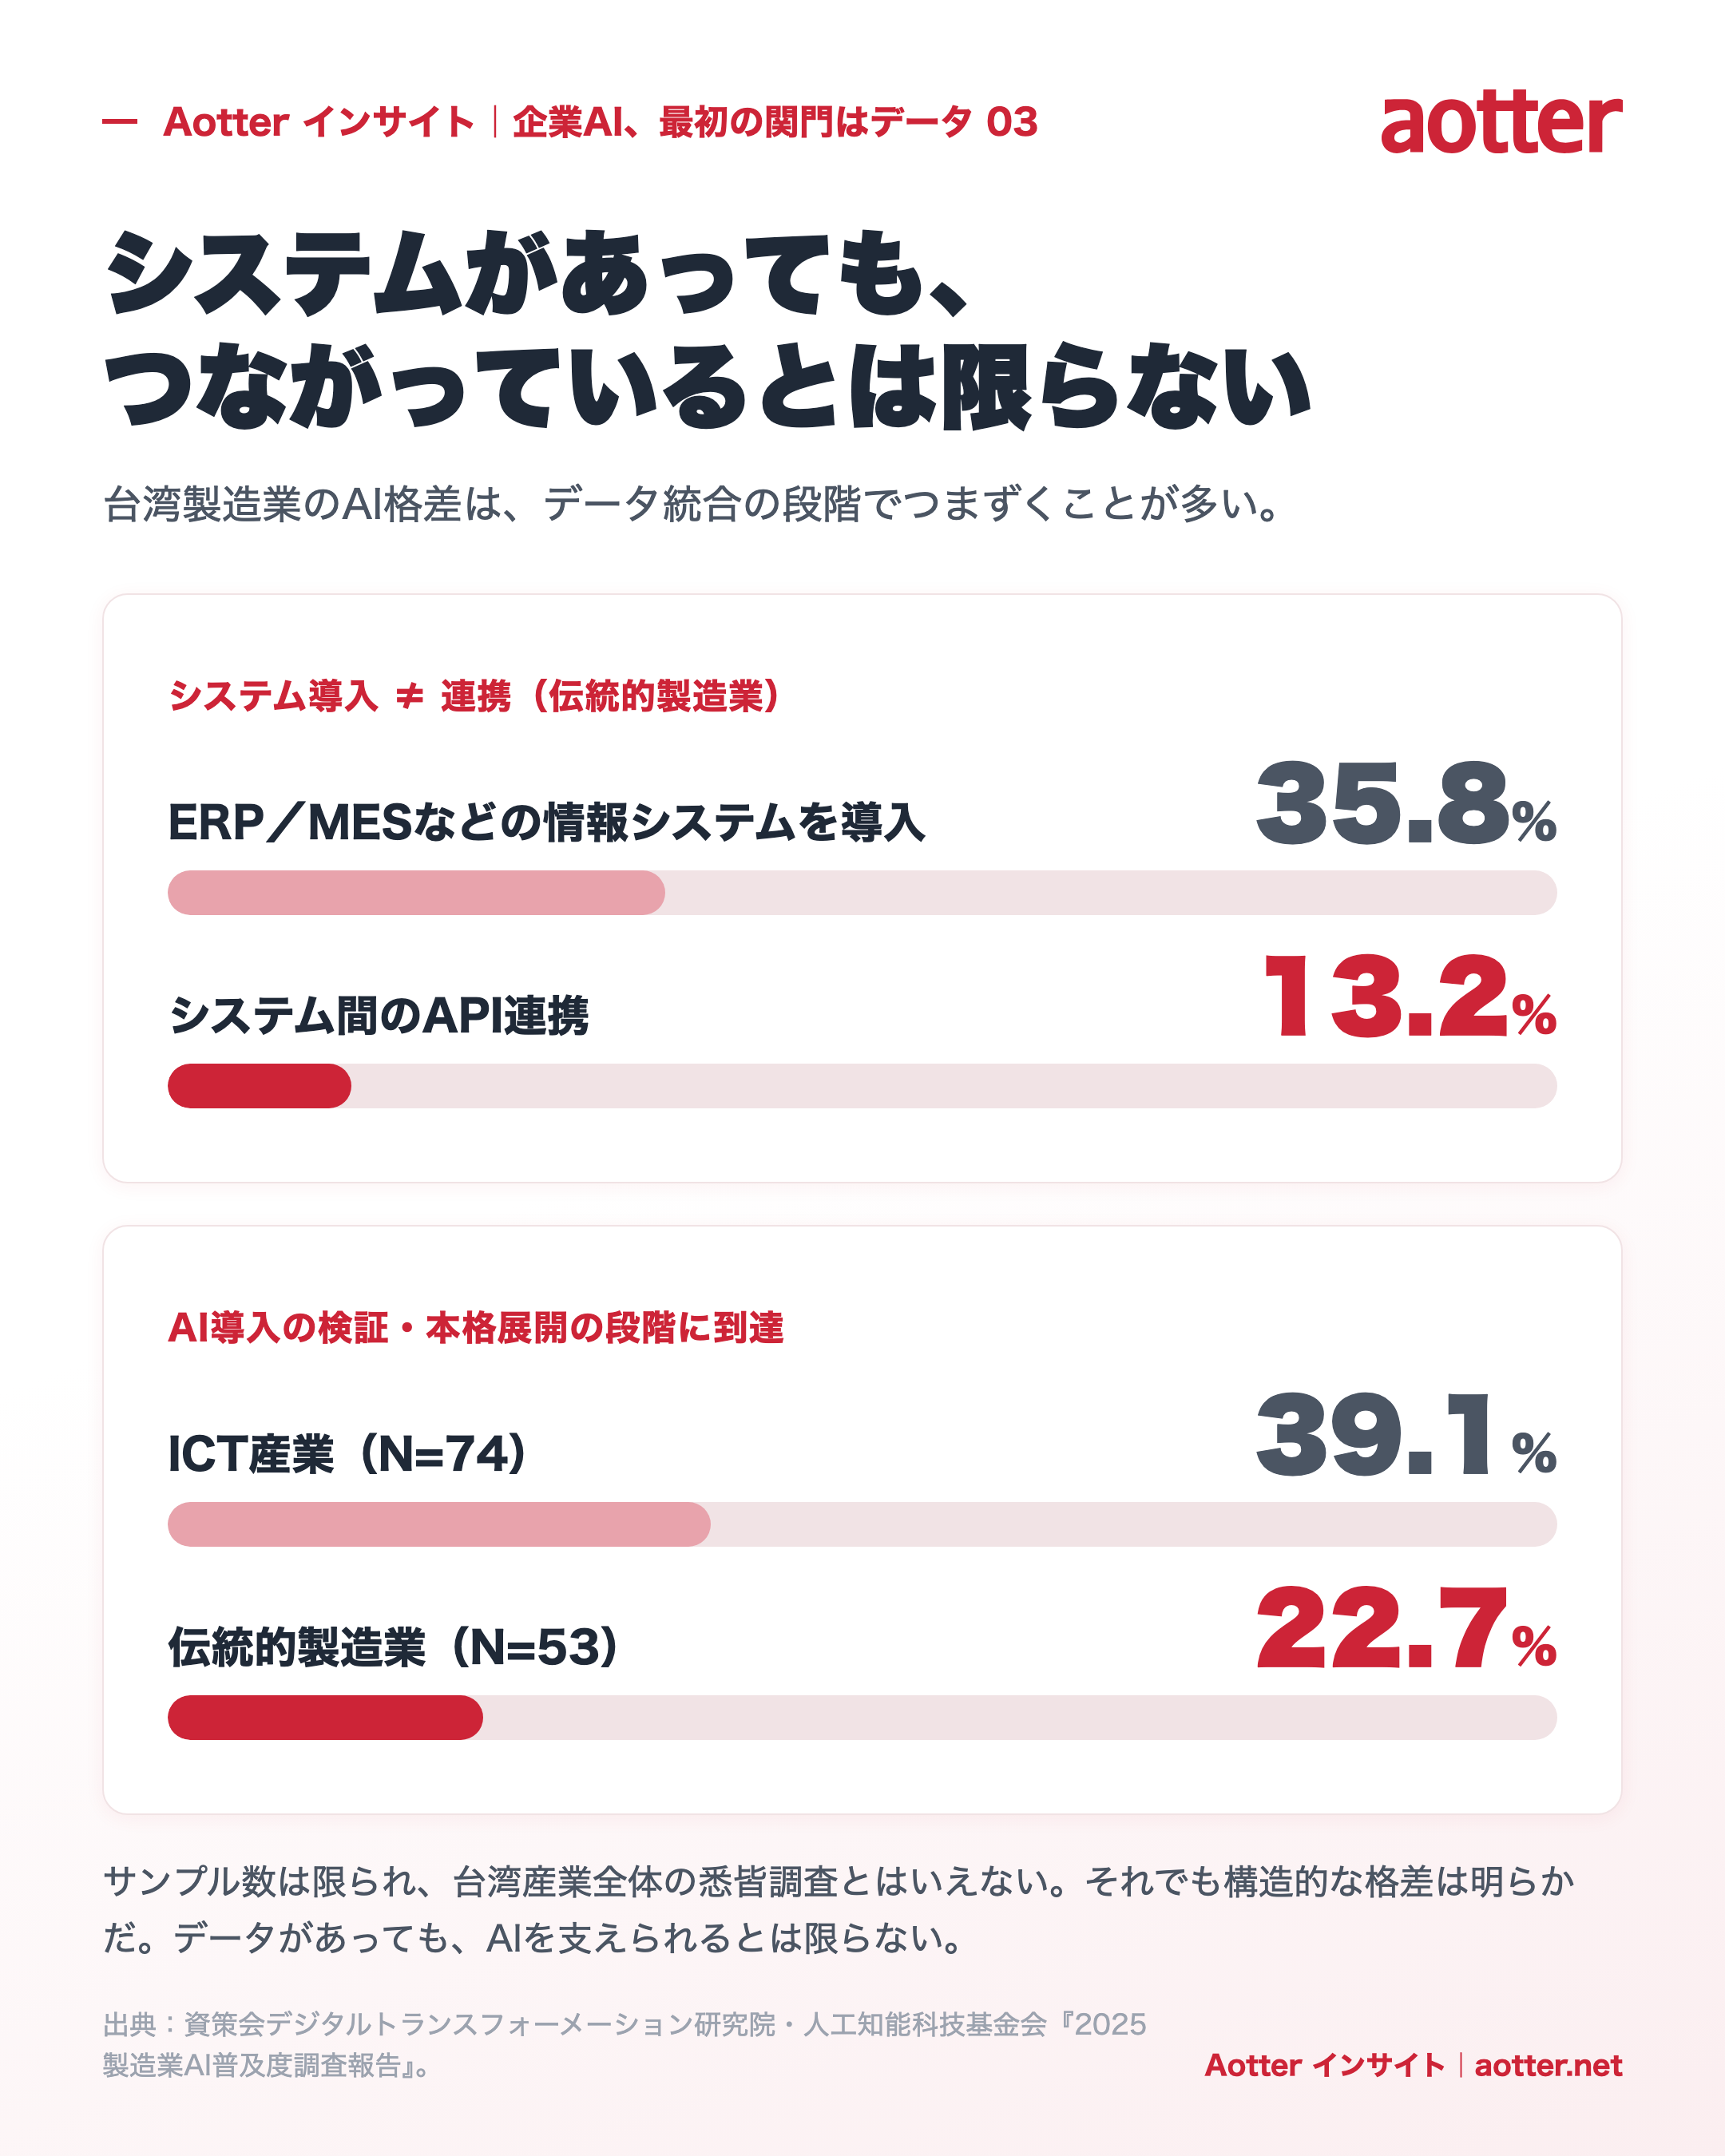
台湾のローカル調査も、この問題をより具体的にしています。資策會デジタルトランスフォーメーション研究院と人工知能科技基金会による 2025 年製造業 AI 普及度調査は、従来型製造業と ICT 産業を分けて観察しています。報告によると、従来型製造業の回答サンプルのうち、35.8% が ERP や MES などの情報システムを導入し、システム間 API 統合比率は 13.2%。従来型製造業が AI 導入の検証段階や規模化段階に進んでいる比率は 22.7% で、ICT 産業の 39.1% よりも低くなっています。この研究のサンプル規模は限られており、グループごとのサンプルはそれぞれ従来型製造業 53 社と ICT 産業 74 社であるため、台湾産業全体の精確な全数調査結果として直接推論すべきではありません。しかし、これは構造的な格差を非常に明確に示しています。システムがあることは、システム同士が通じ合うことを意味しません。データがあることも、データが既に AI を支えられることを意味しません。4
企業が私たちにデータクリーニングについて相談しに来るとき、よく聞く答えは「まず人を見つけてデータを抽出し、ETL を行い、整理してから倉庫に入れる」というものです。ETL とはデータの抽出、変換、ロードのプロセスを指し、本来からデータエンジニアリングの重要な仕事です。しかし、すべての種類のレポートに対して毎回一から処理プログラムをカスタマイズする必要があり、データ形式が変わるたびに修正が必要で、後任者も過去のルールを再度理解しなければならないとなると、導入コストはなかなか下がりません。企業が必要としているのは、データクリーニングが簡単であるかのように装うことではなく、大量の繰り返しが可能で、記述可能で、検証可能なステップを、再利用可能なルールに整理することです。
そこで私たちは、一見とても単純な質問を自問し始めました。Excel の形式は千変万化ですが、それでも明確に記述できる安定したデータ処理の「原子」が存在するのではないか?ある表をどう読むべきか、どの行を除外すべきか、列をどの型に変換すべきか、どうやって一件のレコードを判断するか、どうやって別の表と関連を構築するか、そして新しいファイルが入ってきたらどう更新するか。これらの作業はもちろん AI を加えただけで自然にリスクがゼロになるわけではありませんが、定義、ルール、検証、実行に分解することができ、毎回「以前はだいたいこうやっていた」と記憶している特定の同僚に頼るだけではなくなります。
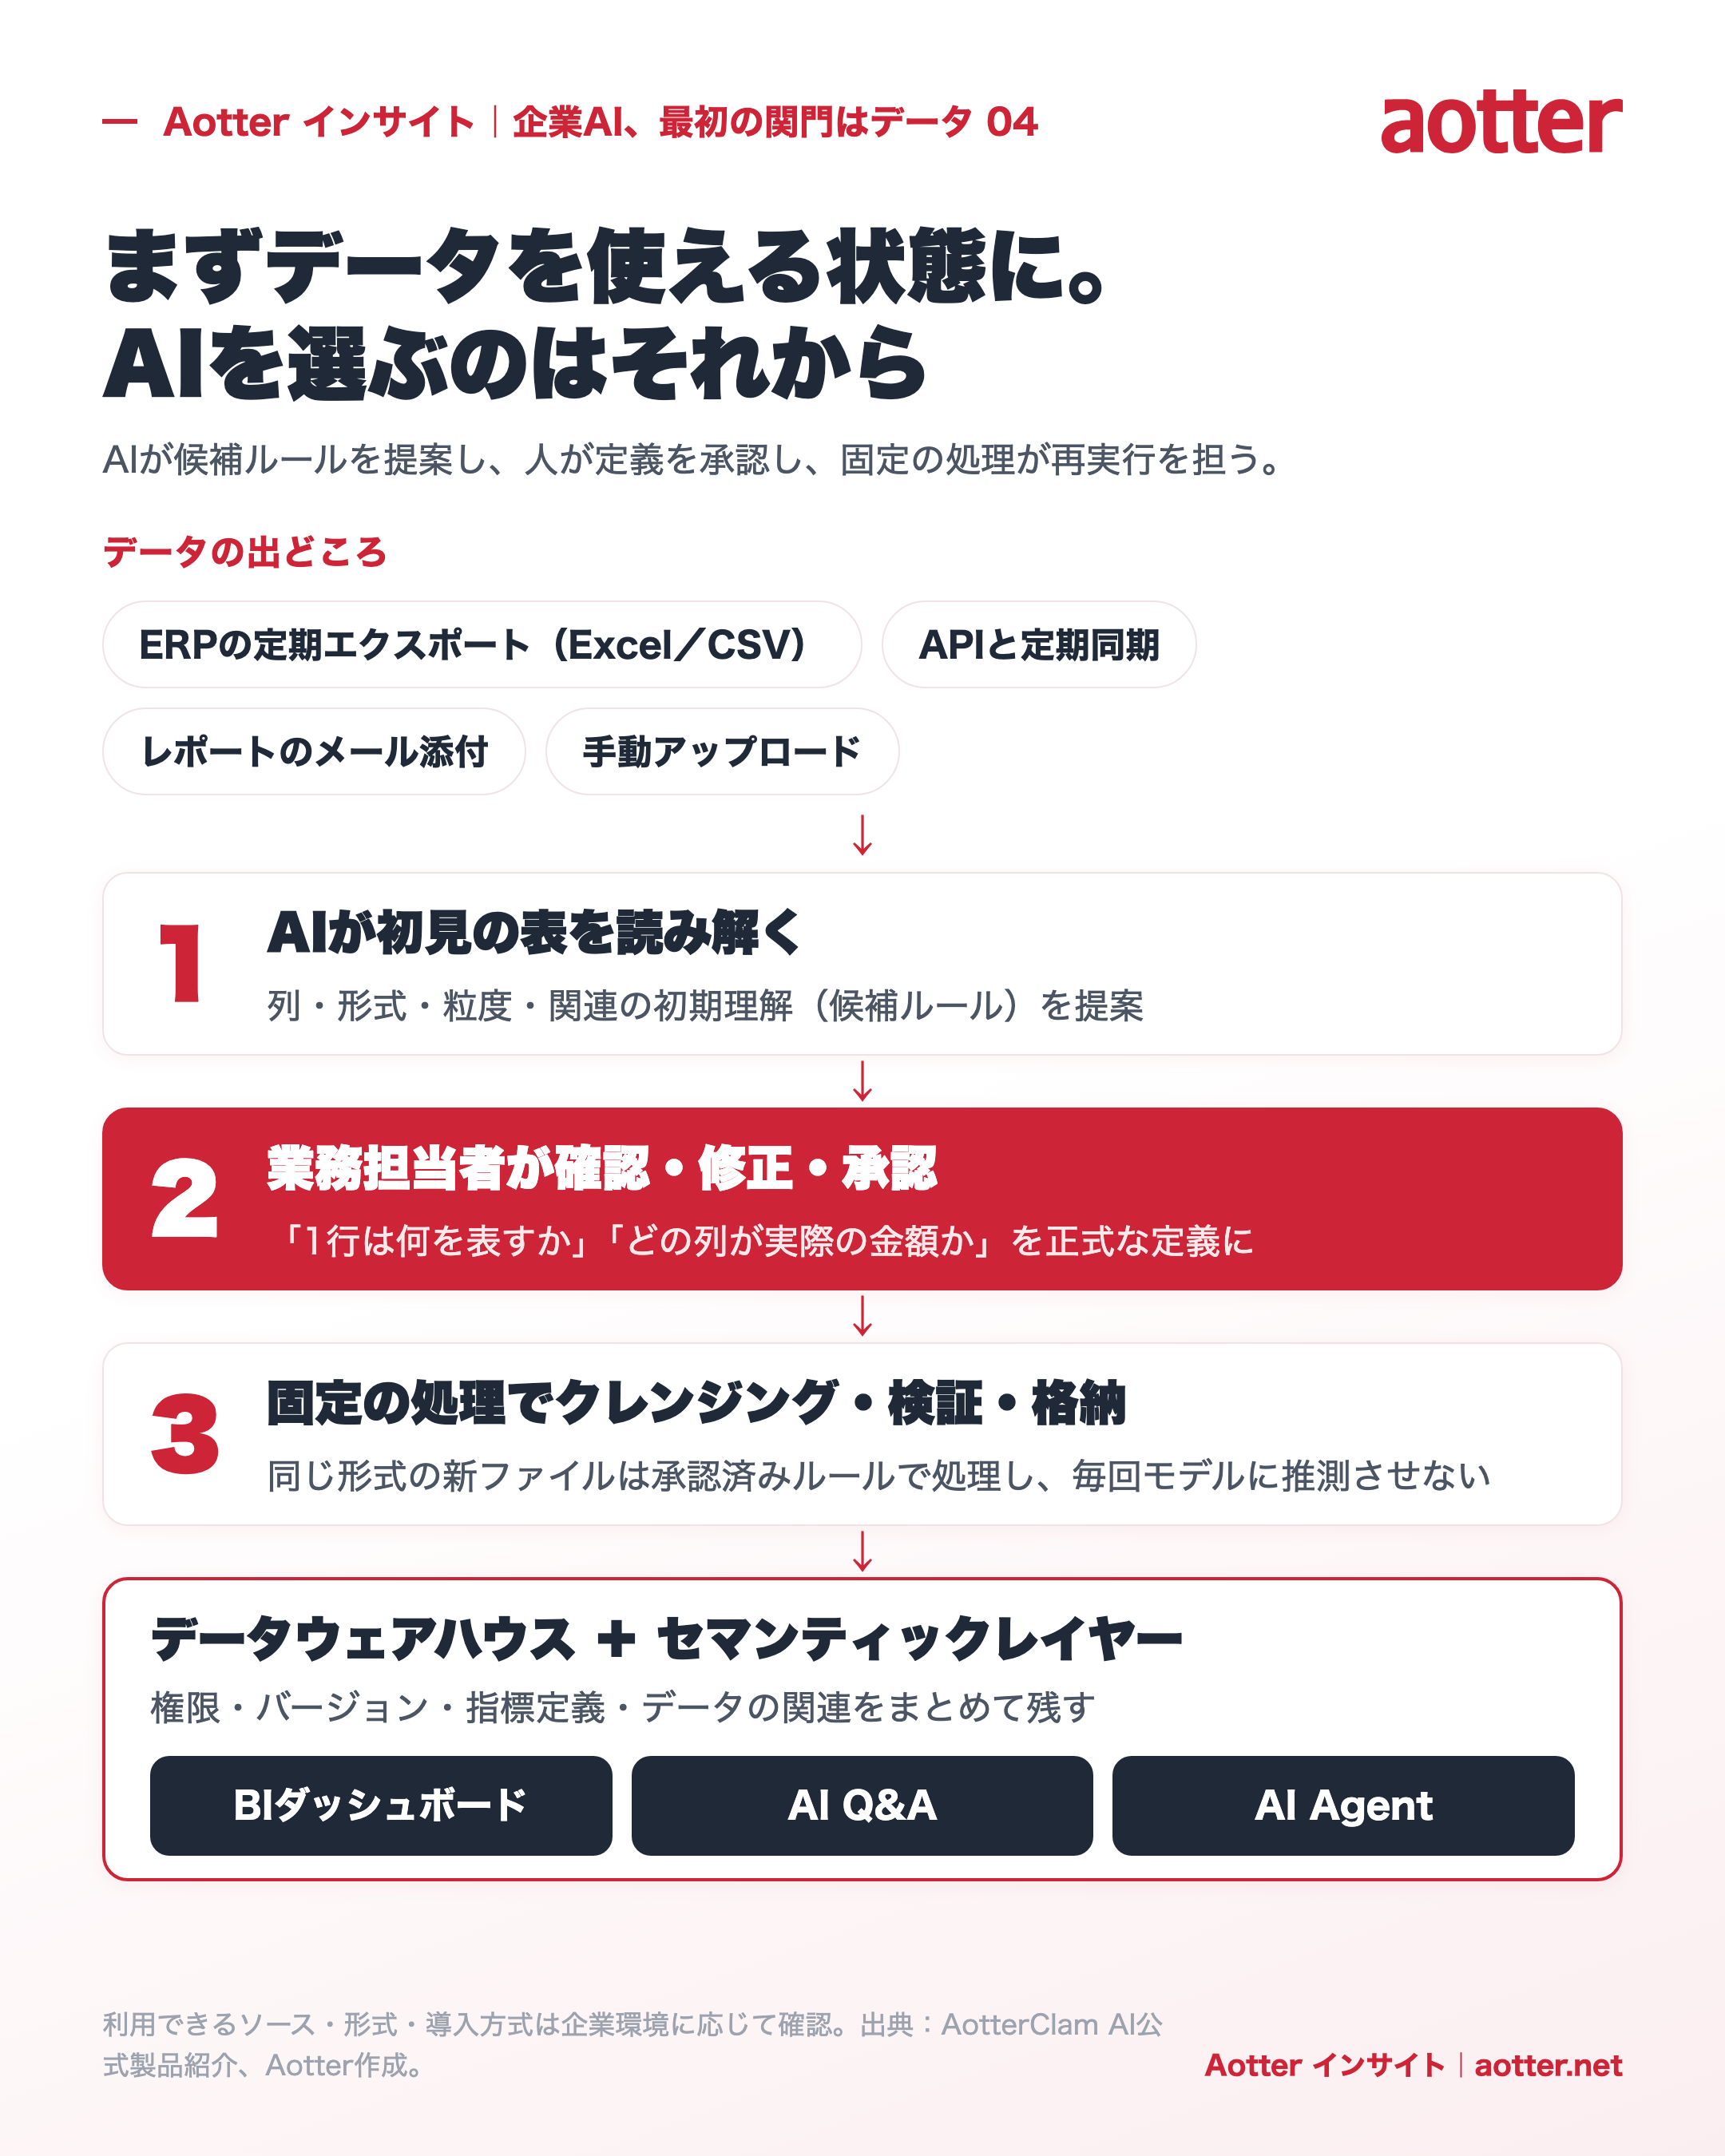
数ヶ月の研究を経て、私たちはデータサイエンスとデータエンジニアリングで繰り返し現れる処理方法を、一セットの宣言的な文法に整理しました。いわゆる宣言的とは、目標とルールを明確に書き出すことです。例えば「この列は注文日を表す」「小計行は明細に入れない」「注文番号と品目番号で一件のデータを識別する」「金額は値引き後の純額で計算する」といったように、毎回引き継ぎにくい手作業のプロセスだけを残すのではありません。AI はまず見たことのない Excel を分析し、列、形式、関連についての初歩的な理解を提示できます。続いてビジネスに精通した人がチェックと修正を行い、承認された定義を保存し、固定されたプロセスに渡して以降のファイルを処理させます。
データの取り込みも、同僚の手作業アップロードだけに頼る必要はありません。企業が既存の ERP で定期的にレポートをエクスポートできるなら、既存のスケジュールに沿って Excel や CSV を送ることを継続できますし、システムに API があれば直接接続することもできます。エクスポートファイルが到着した後、システムは承認された定義に従ってクリーニング、検証、更新、倉庫への取り込みを行います。AotterClam AI の公式プロダクト説明を例にとると、現在 Excel と CSV ファイルのインポート、API とスケジュール同期、そしてレポートメールの添付ファイルを自動処理する方式などが挙げられています。実際に利用可能なソース、形式、デプロイ方式は、企業の環境に応じてケースごとに確認する必要があります。5
この設計思想のポイントは、AI に永遠に人間の判断を代替させることではなく、AI が最も得意とする作業を「未整理のデータを理解し、候補ルールを提示する」という位置に置くことです。ビジネス側の確認は「列と指標の意味を判断する」という位置に置き、固定ルールは再現可能なデータフローに実行させます。こうすることで、データエンジニアリングは毎回のインポートのたびにモデルを再び呼び出し、再び推測する必要がなく安定性を失うこともなく、ビジネス担当者も毎回の照会時に表全体の背景を再度説明する必要がなくなります。
私たちが最も重視する六つのプロダクト特徴
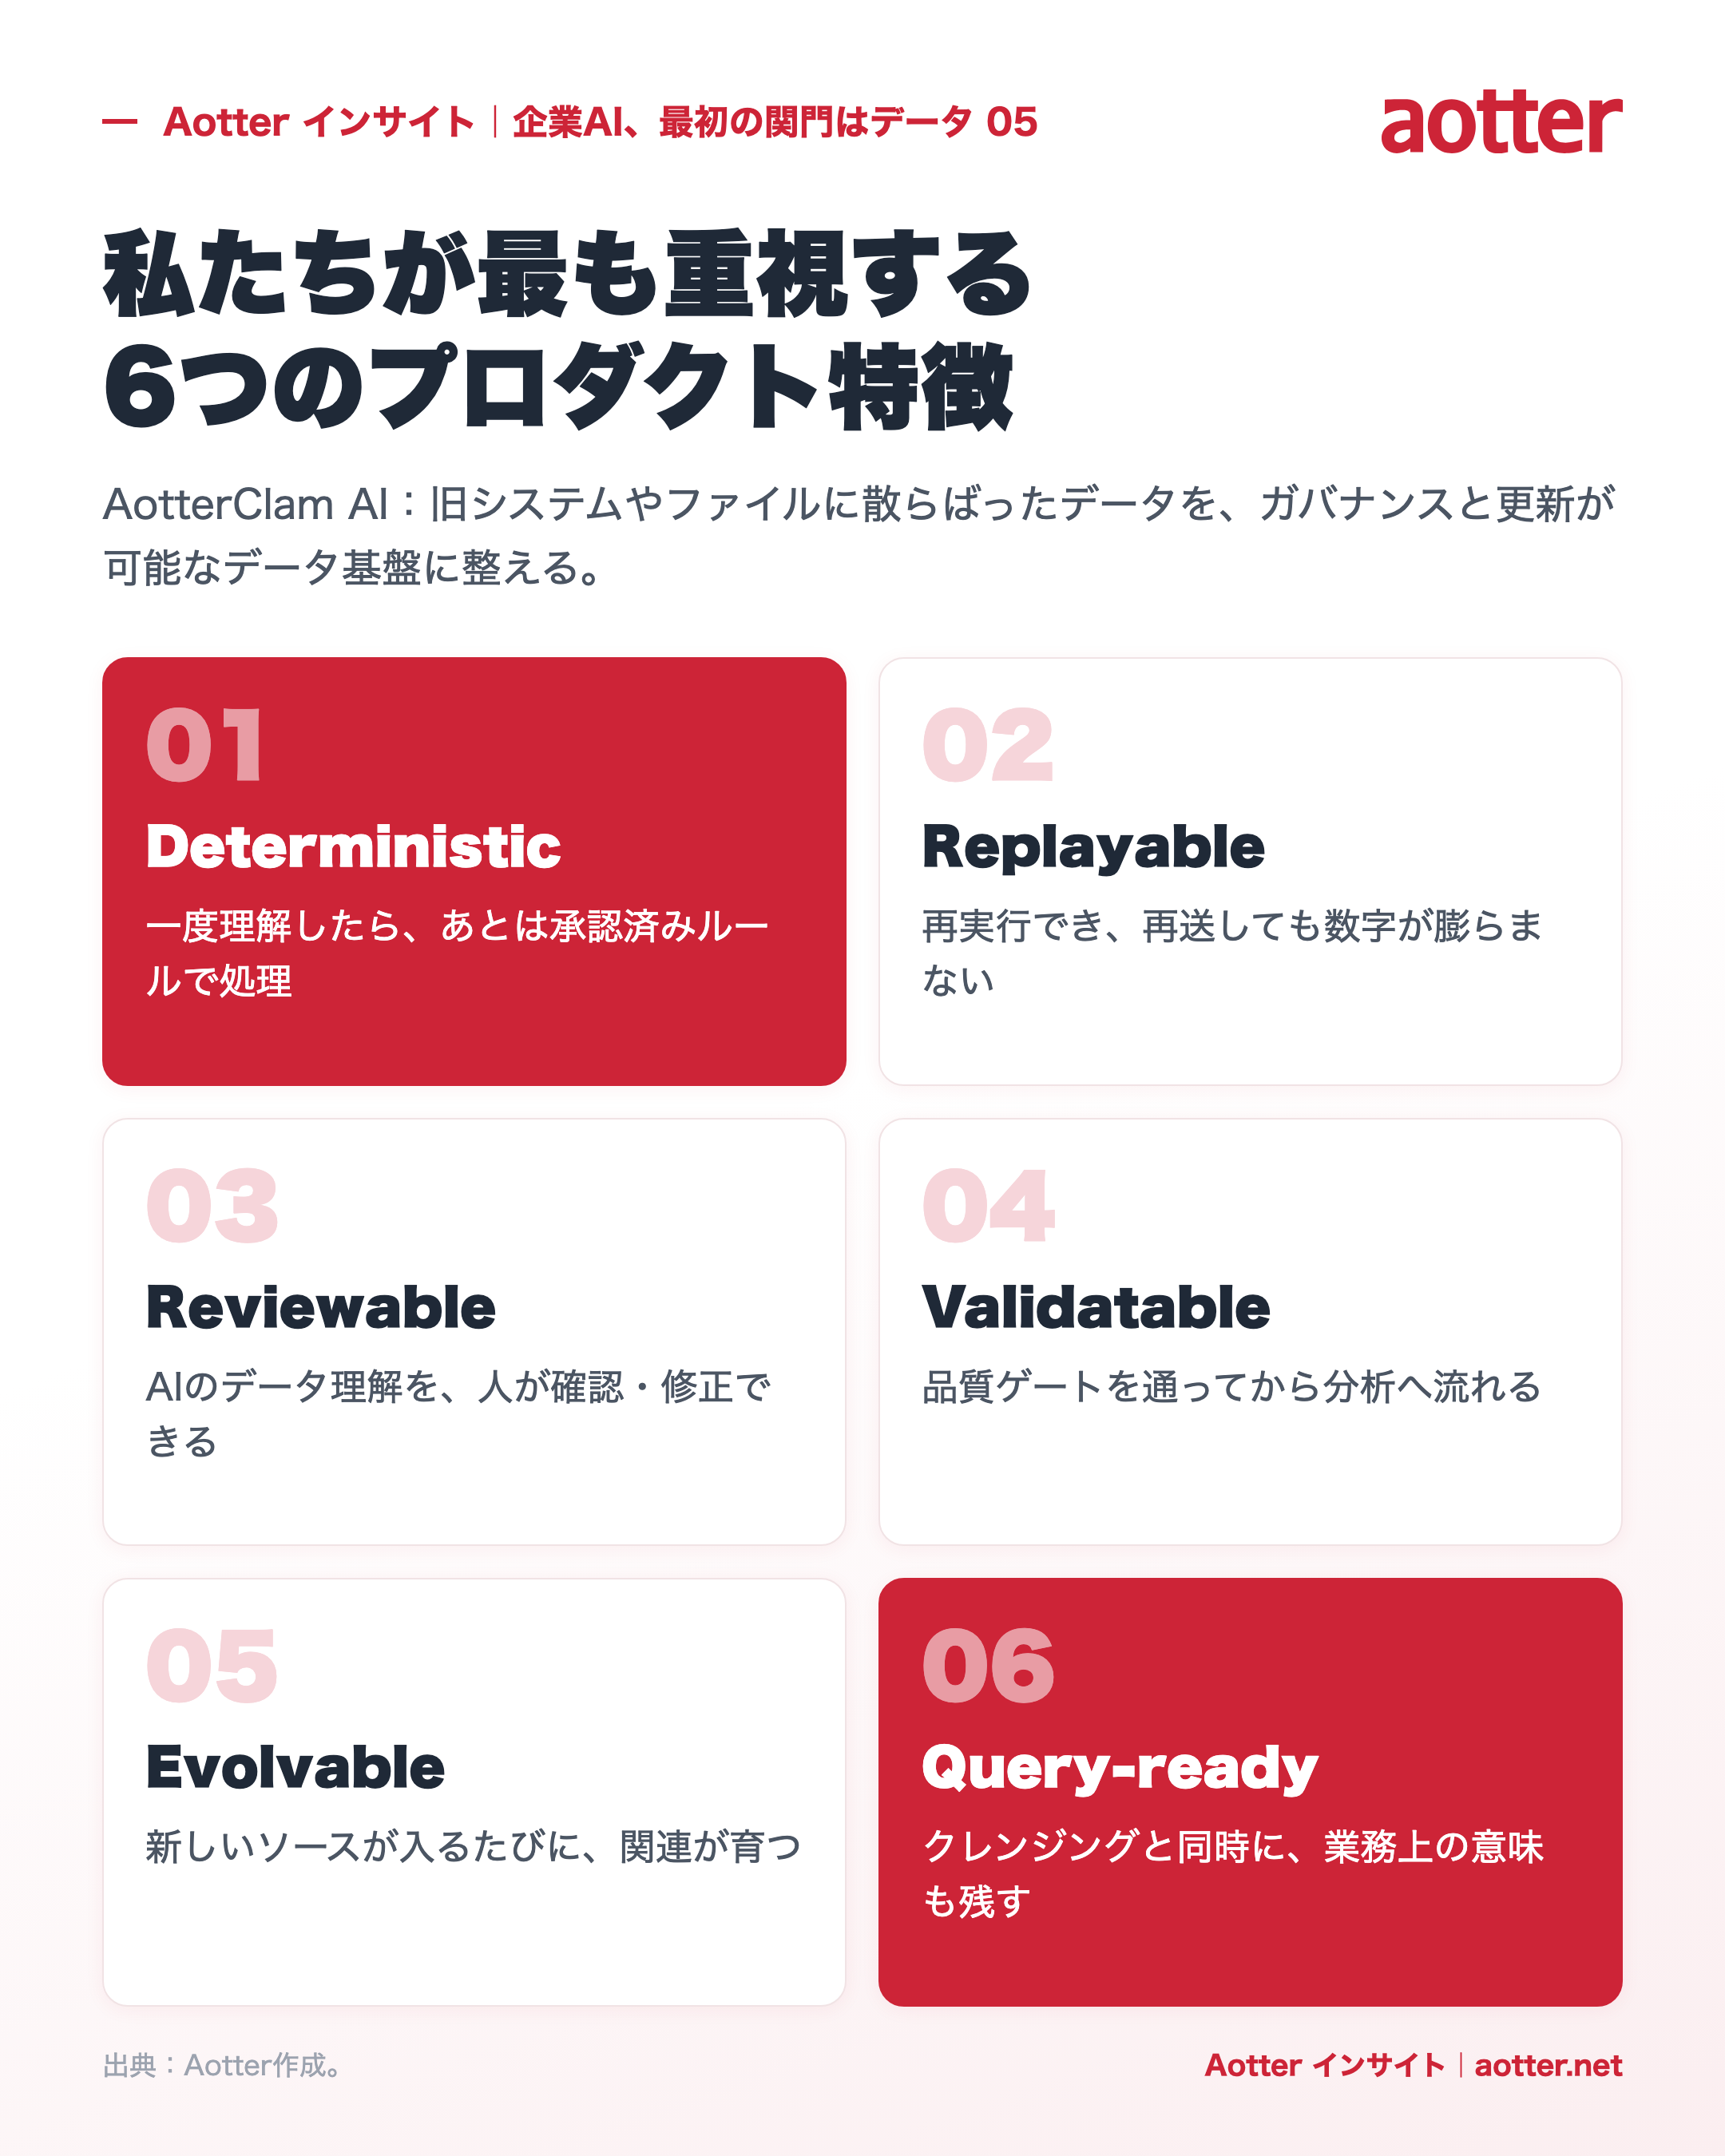
1. Deterministic:一度理解したら、以降は承認済みルールで処理
初めて見知らぬ表に出会ったとき、AI は可能性のあるタイトル行、列名、日付形式、合計行、データの粒度を識別するのを支援できます。それは推測をそのまま正式な真実として扱うのではなく、まず検証可能な定義を提示します。ユーザーが「各行は何を表しているか」「どの列が実際の金額か」「どの行は分析に含めるべきでないか」を確認した後、システムはこれらの判断を正式なルールとして保存します。
次回同じ形式のファイルが来たとき、データパイプラインは承認済みの定義に従って実行され、毎回モデルのリソースを消費して各列の用途を推測し直す必要はありません。これが deterministic の核心です。毎回のクリーニングを新しい対話として扱うのではなく、既にビジネス側の確認を経たステップを繰り返し実行可能な手順にするのです。
しかし deterministic は永遠にエラーが発生しないという意味ではありません。データソースが仕様変更されることもあれば、サプライヤーが列名を変更することもあり、同じシステムでも部門ごとにエクスポートされるファイル形式が異なることさえあります。固定ルールが互換性のない変化に遭遇したとき、正しい対応はエラーデータを無理やり倉庫に押し込むことではなく、構造の変化を検出し、影響を受けたデータを一時停止または隔離し、人に確認を求めることです。安定性は明確なルールと変更管理から来るものであり、「AI が一度学習すれば、以降は何も管理しなくていい」と主張することではありません。
2. Replayable:再実行可能であり、かつ再送信によって数値が水増しされない
企業のデータインポートではほぼ必ず再送信に遭遇します。レポートを間違えて送って再送したり、同じファイルを二回アップロードしたり、スケジュール実行が中断して再実行したり、経理担当が月末に先月の記録を修正したりするのは日常的な状況です。もしシステムが受け取った内容を単純にデータテーブルの後ろに追加するだけなら、一度再実行するだけで売上、注文数、在庫量が何もないところから倍増してしまう可能性があります。
そのため、システムはどのような条件で同一のビジネスデータを識別できるかを知る必要があります。注文番号と商品明細番号の組み合わせかもしれませんし、店舗コード、取引日、連番を組み合わせる必要があるかもしれません。この識別方式は企業のビジネス定義によって決定されるべきで、ファイル名や行番号だけを永続的な一意キーとして扱うべきではありません。同じレコードが再び現れたとき、システムはルールに従って既存のデータを更新するか、それを重複項目として識別できる必要があり、無条件に積み重ねるべきではありません。
再実行可能であることは、修正にも正式なフローを与えます。仮に過去に日付をテキストとして読み込んでしまった、値引き欄の減算を漏らしていた、あるいは同一注文の商品行が誤って合計されていたことに気づいたとしても、元のファイル、処理定義のバージョン、実行記録を保存しておけば、先にルールを修正し、影響を受けた期間のデータを再処理することができます。これによりデータの結果は追跡可能となり、企業は「この数字はどこから来たのか」「どのバージョンのルールがこのレポートを生成したのか」に答える機会を持てます。
注意すべきは、データを再生可能にすることは、すべての元ファイルを無制限に保存する理由にはならないということです。元データに個人情報が含まれているかどうか、保存期限をどう設定するか、誰が再実行する権限を持つか、旧バージョンは削除またはマスキングすべきかどうかは、すべて企業の既存のデータポリシーに組み込まれなければなりません。再実行能力が解決するのは技術的な復元可能性であり、企業のデータ保存と個人情報管理の責任を自動的に完了させるものではありません。
3. Reviewable:AI がデータをどう理解しているかを、人がチェックし修正できる
多くのデータ整理の経験は、ベテラン社員の頭の中だけに存在しています。皆、「レポートの上のあの二行は要らない」と知っていたり、ある列が「状態」と書かれていても実は出荷状態を表していると知っていたり、二つのリストをどのコードで対応させればよいか知っていたりします。短期的に見れば、その同僚に聞くのが最も早い方法です。しかし長期的に見れば、これらの重要な知識が記録されなければ、業務の引き継ぎ、組織の調整、人員の離職とともに消えてしまいます。
Reviewable の意味は、AI のデータに対する理解を広げてチェックできるようにすることです。列はどう命名されているか、列の型は何か、各行は注文を表すのか注文品目を表すのか、どの列を合計できるか、どのデータを除外すべきか、異なるソースをどう接続するか。ビジネス担当者はドメイン知識を補足でき、データ担当者は技術設定を確認でき、管理者は指標の定義が経営上の口径に合致しているかを確認できます。これは承認プロセスを増やすためではなく、もともと口頭伝承にのみ頼っていたデータルールを、組織が共同でメンテナンスできる資産に変えるためです。
検証可能性には変更記録も含まれるべきです。ある列の定義が「売上」から「返金を控除した純売上」に変わったとき、企業は誰がいつルールを調整したのか、影響を受けたダッシュボードはどれか、旧レポートが依然として旧口径を採用しているかどうかを知ることができるべきです。データ定義は一度作ったら永遠に変わらないものではなく、ビジネスプロセス、プロダクト形態、法規要件とともに進化していきます。追跡可能なバージョン管理は、同じ名称が異なる部門でそれぞれ異なる数字を表すことを防げます。
4. Validatable:データはまず検査を通過してから、分析と AI の問答フローに流れる
自動化は単にエラーをより速く走らせるだけであってはいけません。データ列が存在しない、日付形式が期待と合わない、商品コードが対応する商品を見つけられない、注文総額と明細の合計との差が大きすぎる、これらの問題はすべてデータが分析層に入る前に指摘されるべきです。
私たちは検証を品質ゲートと考えています。基本チェックでは列が存在するか、型が正しいか、必須列に空値がないか、主キーが重複していないかを確認できます。さらにビジネスルールを加えます。例えば取引日はインポート日より大幅に後になってはいけない、割引は元の金額より大きくてはいけない、キャンセルされた注文は有効な売上に計上すべきでない、各店舗は毎週データが必ずあるべき、といったものです。財務や在庫データについては、元の ERP の集計数値との照合も重要です。そうしなければ、形式上は正しく見えるファイルでも、ある変換ステップで丸ごとデータが漏れている可能性があります。
検証結果は「合格」か「不合格」の二択だけである必要はありません。エラーが取引金額や個人識別情報のような高リスクの列に関わる場合、システムはまずデータを隔離し、人に確認を求めることができます。重要でない備考欄に新しい形式が増えただけであれば、警告をマークしつつ他の列の処理を続けることもできます。警告のレベルとビジネスへの影響を分けることで、「完全に停止する」か「すべての異常を無視する」かという二者択一を避けられます。
人工知能科技基金会は 2025 年台湾産業 AI 化調査の中で、専門家インタビューを通じてデータ標準、データ品質、応用シナリオは一緒に考慮しなければならないと述べています。データは保存されているだけではガバナンスが完了したことにはならず、実際の意思決定を支えられるかどうか、責任者がいるかどうか、データが変化したときに発見し修正できるかどうかも知る必要があります。6
5. Evolvable:新しいソースが入ってきても、既存のデータが段階的に新しい関連を育てられる
企業はすべての部門がデータの棚卸しを完了するまで待ってから、最初の分析プロジェクトを始める必要はありません。最初は売上明細しかなくても、まず「最近どの商品がよく売れているか」に答えられます。後で在庫表を加えれば、「どの商品が売上増加しているのに、在庫が徐々に不足しているか」が見えるようになります。さらに顧客や会員データを接続すれば、「異なる顧客層が何を買っているか、リピート購入の間隔はどれくらいか」を理解する機会が得られます。データモデルは本当の必要性に応じて段階的に拡張でき、プロジェクト開始時に企業のすべてのソースを一度に揃える必要はありません。
しかし、新しいデータを追加するというのも、似たようなテキスト列を持つ二つの表を単純に直接接続すればよいというものではありません。商品名には略称、スペース、新旧の品名があるかもしれず、異なるシステムの顧客番号もそれぞれ独立しているかもしれません。関連を構築する際は、双方の識別キーが安定しているか、データが一対多か多対多か、履歴記録を保持する必要があるか、マッチしなかった項目をどう処理するかを確認する必要があります。「台北店舗」と「台北店」を誤って二つの異なる店舗として扱ったり、同名の二人の顧客を合併してしまったりすると、後続の AI による解釈がいくら流暢でも、データモデルの誤りを救うことはできません。
モデルを進化可能にするもう一つの利点は、企業が新しいソースを追加するたびにデータの価値を拡大するチャンスとして捉えられることです。以前は月間売上しかなかったとき、管理者は結果しか見られませんでした。プロモーション活動と在庫変化を加えれば、活動前後の在庫回転と売上の差異を比較できます。さらにカスタマーサービスのフィードバックを取り込めば、人気商品の返品理由まで追跡できます。データ間の関連が段階的に増えるにつれ、古いデータも新しい文脈によってより多くの質問に答えられるようになるかもしれません。
6. Query-ready:データをクリーニングする際、ビジネスの意味も同時に残しておく
空白を削除し、日付を統一し、誤字を修正するのは、データ整理のほんの一部に過ぎません。もしデータが倉庫に入った後も「商品」「注文」「顧客」がそれぞれ何を指すのか分からず、どの列が正式な売上なのか分からず、二つの表をどう接続すべきか明確でなければ、AI の問答は毎回また一から推測し直すことになり、一見合理的に見える答えの中で気づきにくいミスを犯す可能性さえあります。
そこで私たちは、データクリーニングの段階で、最も基本的な意味論レイヤー(semantic layer)を一緒に構築することを目指しています。意味論レイヤーはデータの列を企業が実際に使用している概念に変換します。一件の売上の粒度は何か、純売上はどう計算するか、返金はどう控除すべきか、商品分類はどのコードを採用するか、日付は取引日を基準にするか出荷日を基準にするか、そして異なるデータセットの関連はどう構築するか。こうすることの目的は、BI ツールや AI が照会する際に明確なビジネス上の文脈を持てるようにし、列名を見ただけで勝手に推測しなくてもよいようにすることです。
同じ指標でも、異なる状況下で異なるバージョンを持つことがあります。財務部門は請求書で計上された売上を基準にするかもしれませんし、運営チームは既に出荷された注文を基準に売上を観察するかもしれません。マーケティング部門はキャンセル注文を控除した後の活動コンバージョンを見たいと思うかもしれません。これらの口径を無理に一つの答えに統一する必要はありません。より現実的なやり方は、各指標の名称、計算方法、適用シナリオ、責任者を明確にし、ユーザーが質問する際にシステムがどの口径を適用すべきか分かるようにすることです。
データの粒度、関連、指標の計算方式が明確に記述されると、AI の仕事は中国語(日本語)の質問をデータベースクエリに翻訳するだけではなくなります。意味論レイヤーに基づいて、質問の中で言及されているのがどの種類の売上なのか、どの期間なのか、どの商品の次元なのか、どのデータを混ぜて加算すべきでないかを識別することもできます。もちろん、意味論レイヤーも依然としてビジネス責任者の承認が必要です。それは列名からすべてのビジネスロジックを自動的に導き出せる魔法のモジュールではありません。
データウェアハウスから上へ:AI が日常業務に入り込むために
データを整理することは、企業の変革が終わったことを意味するわけではありません。それはむしろ地盤を固めることに近く、後続のデータ分析、BI ダッシュボード、自然言語の問答、AI エージェントが従うことのできるデータソースを用意することです。データの基盤に権限、バージョン、定義がなければ、上層の AI はおそらくより速く、一見完全に見えるが実際には口径が一致しない答えを生み出すだけになるでしょう。
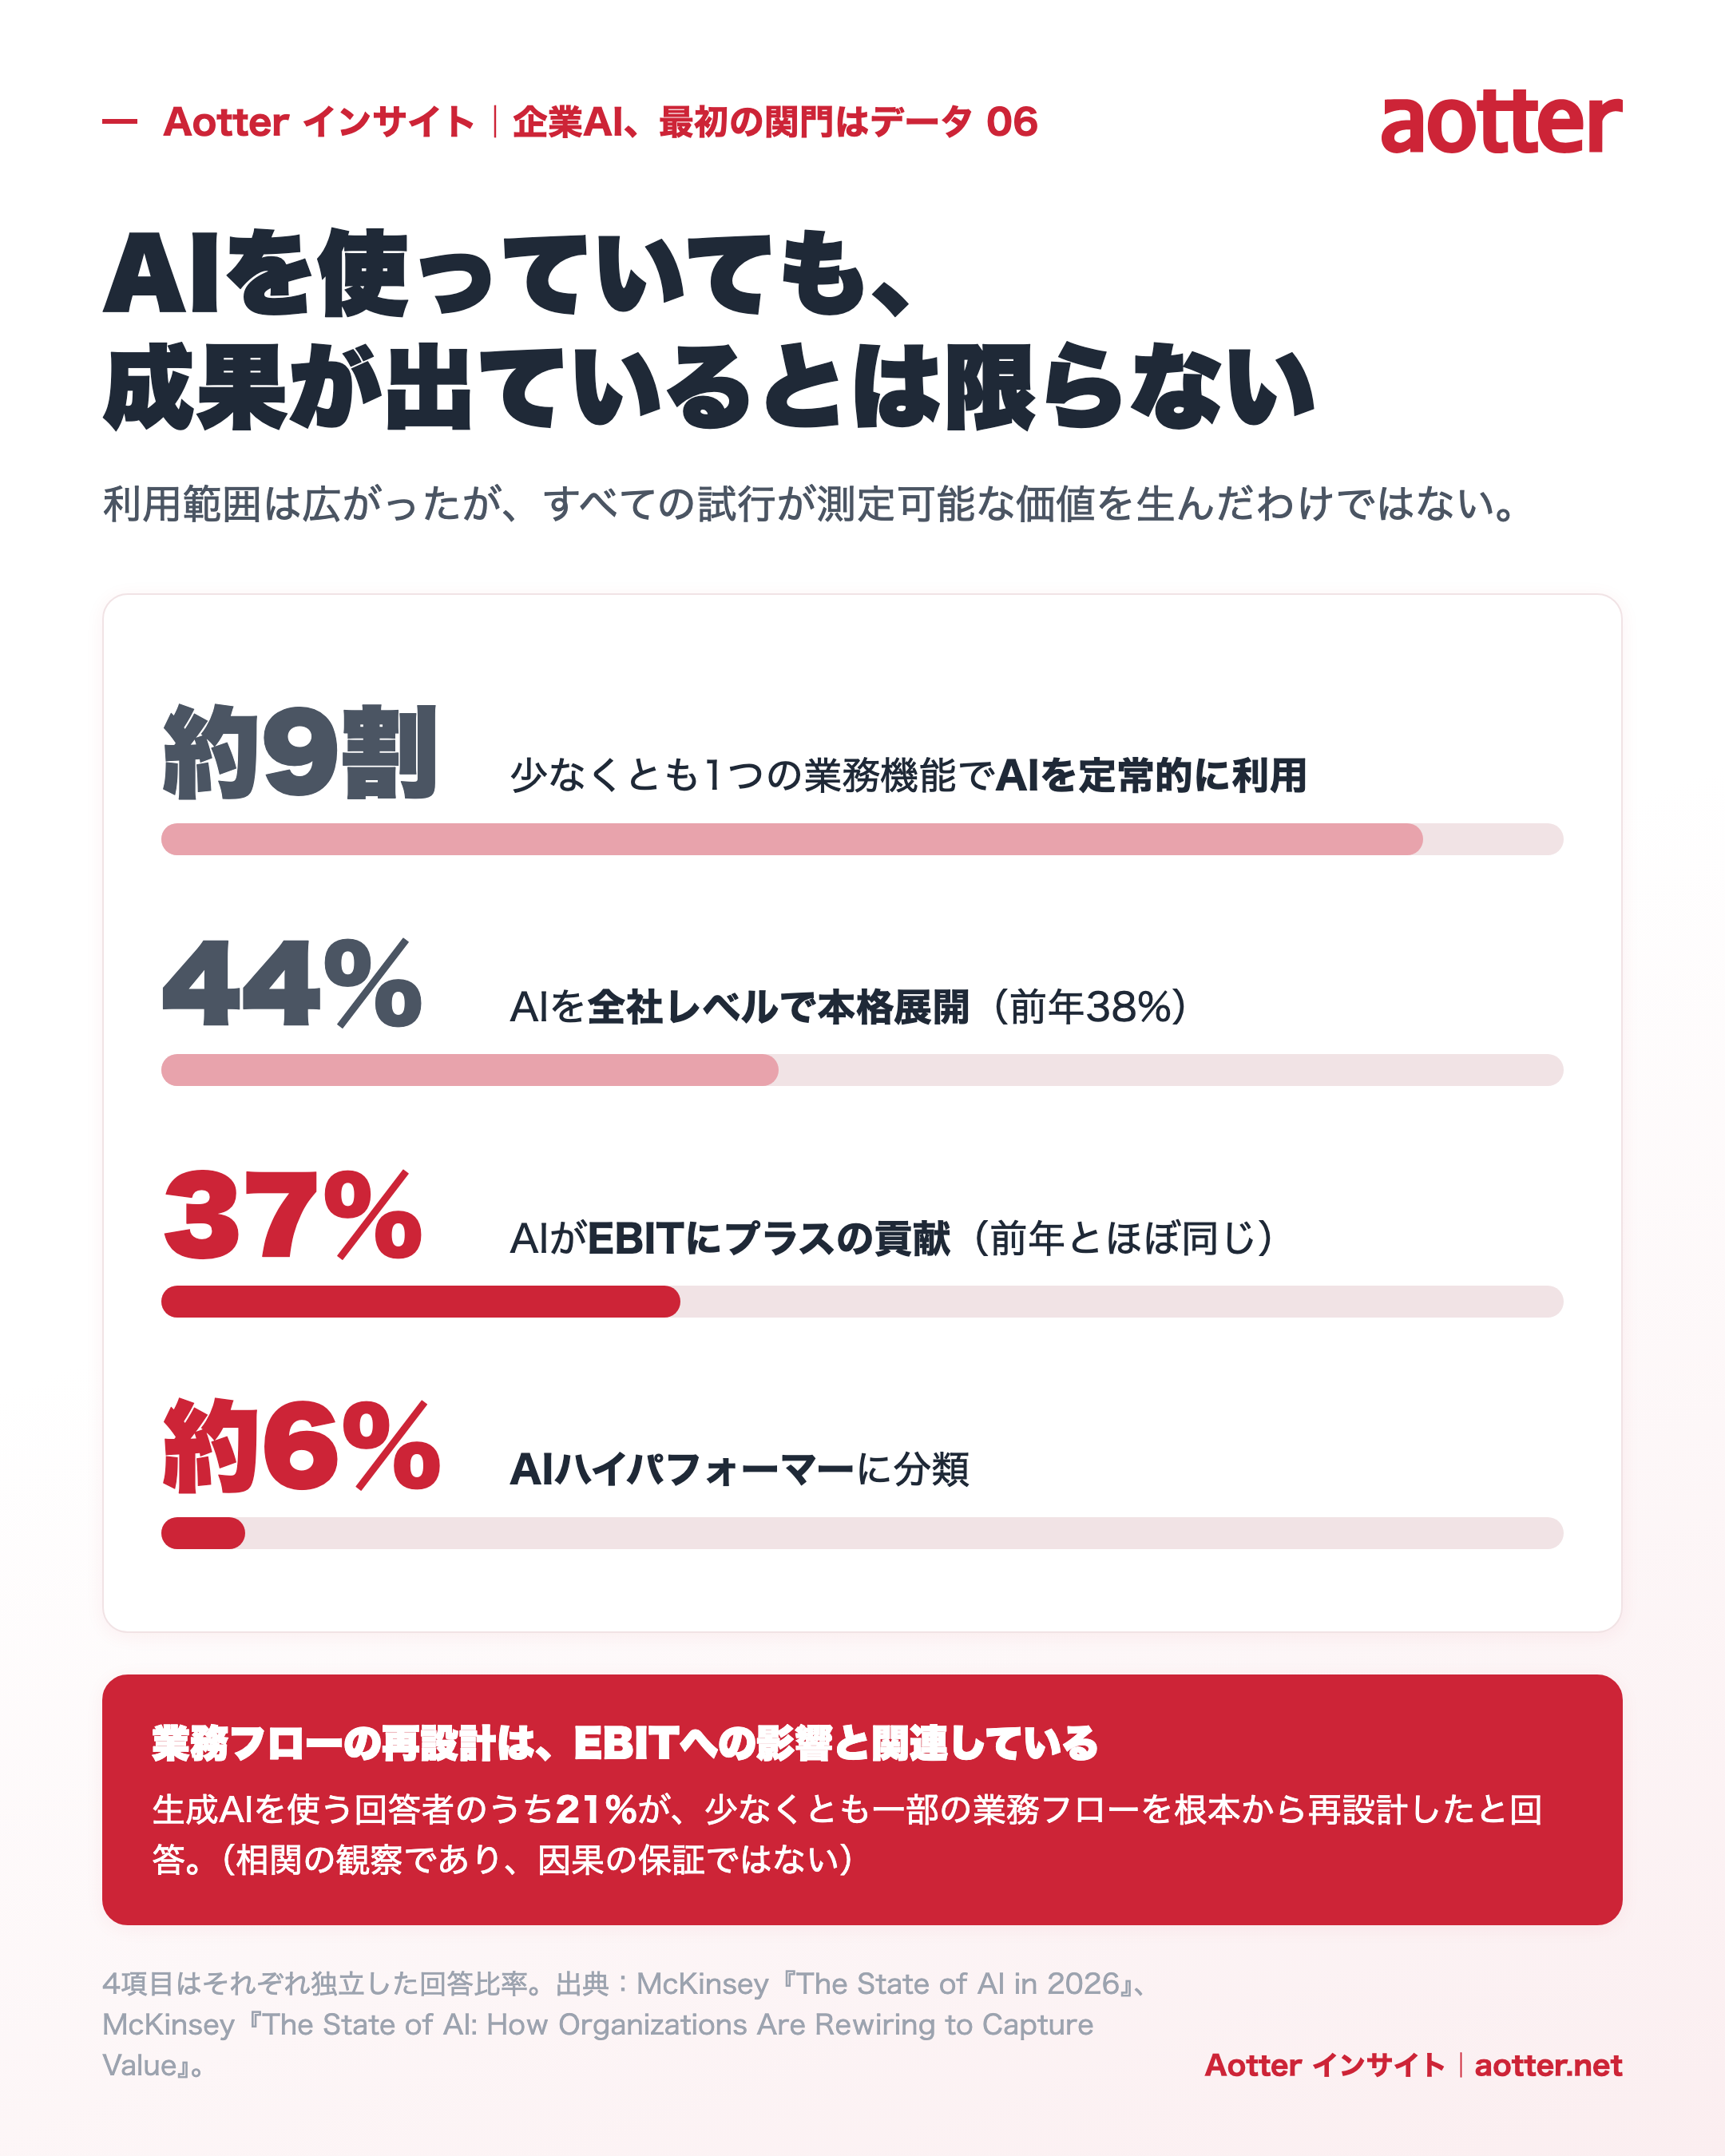
McKinsey の 2026 年《State of AI》調査によると、回答者の約 9 割が所属組織が少なくとも一つのビジネス機能で定期的に AI を使用していると答え、44% が AI が既に企業レベルで拡大展開されていると答えており、これは前年の 38% を上回っています。しかし「使っている」ことは「既に全面的に財務上のリターンを得ている」ことを意味しません。37% の回答者が AI が企業の EBIT にプラスの貢献をしていると答えており、この比率は前年とほぼ同程度です。約 6% が AI ハイパフォーマンス組織に分類されています。これらの数字は企業が立ち止まって考えるべきものです。AI の使用範囲は拡大していますが、すべてのパイロットプロジェクトが既に測定可能な運営価値を形成しているわけではないことを示しています。7
McKinsey の別の分析では、ワークフローの再設計が、回答組織が生成系 AI で EBIT への影響を見られるかどうかに関連する要因の一つであることを指摘しています。生成系 AI を使用している回答者のうち、21% が所属組織が少なくとも一部のワークフローを根本的に再設計したと答えています。これは調査における相関関係の観察であり、プロセスを変えさえすれば必ず利益が向上するという意味ではなく、ましてすべての企業に対する因果関係の保証でもありません。しかしこれは、企業が AI を単に旧来のプロセスの横に付け加えるだけであってはならず、むしろ問うべきであることを示しています。どの意思決定、引き継ぎ、待機、あるいは繰り返しの整理が再設計できるのか、と。8
多くの企業にとって、データが倉庫に入った後、最初に実現可能な変化は必ずしも完全自動の AI エージェントではなく、答えを得るまでの時間を短縮することかもしれません。以前は毎月同僚が数時間かけて ERP、倉庫、売上レポートを統合していましたが、今ではまず固定のフローを自動化し、管理者が自然言語で在庫回転、チャネル別売上、品目の変化を尋ねられるようにできます。次のステップでは、これらの照会結果を補充発注、カスタマーサービス、予算プロセスに接続し、データを単にダッシュボードに表示されるだけのものではなく、実際の行動の根拠にできます。
《デジタルタイムズ(數位時代)》が 2026 年に Aotter と AotterClam AI について報じた記事では、企業が毎月業績、会計、在庫データを整理するシナリオでデータエンジニアリングの問題を説明し、また従来型企業が ERP の再構築を検討した後、代わりに旧システムが出力するレポートを見直し、別途データウェアハウスを構築するという方法を取ったことも報じています。これは個別企業の事例であり、すべての企業が ERP を交換する必要がないと直接推論すべきではありません。しかし、これはよく見落とされる選択肢を指摘しています。もし旧システムが依然として中核的な運営を支えているなら、企業はまず部門横断的なデータ利用方法を改善し、それから全面的な刷新が必要かどうかを評価することができるのです。9
データガバナンスとはデータを鍵をかけて閉じ込めることではなく、データを正しい範囲内で使用させることである
データウェアハウスが照会可能かどうかは、ガバナンスの一部に過ぎません。本当のガバナンスには、データのソースと使用目的、データ品質、列の定義、保存期限、機密度、権限、監査記録、異常処理、責任の所在も含まれます。データが全く使用できなければ価値を生み出せませんが、もし誰もがどんなモデルも制限なくすべてのデータを見られるとしたら、それも成熟したガバナンスではありません。
台湾の《人工知能基本法》は 2025 年 12 月 23 日に立法院で三読を通過しました。数位発展部がまとめた七大原則には、持続可能な発展と福祉、人間の自律性、プライバシー保護とデータガバナンス、情報セキュリティと安全、透明性と説明可能性、公平性と非差別、そして説明責任が含まれます。これらの原則はデータガバナンスを AI 発展の基本的な枠組みの中に組み込んでおり、企業に対して、AI の導入は単にモデルの能力だけに関わるのではなく、データをどう取得するか、誰が責任を負うか、どう開示するか、問題が発生した場合どう追跡するかにも関わることを思い出させてくれます。12
EU の AI Act はリスク等級分けの方式を採用しており、すべての AI 使用状況に完全に同じ要件を適用するわけではありません。特定の高リスクシステムについては、関連ルールがデータセットの品質、リスク管理、活動記録、文書、人的監督、堅牢性とセキュリティなどの側面をカバーしています。EU 公式のスケジュールもその後調整されており、一部の高リスク用途のルールは 2027 年から適用されることになっています。したがって、企業はサービス提供市場、実際の用途、データの種類に応じて適用される義務を確認すべきであり、「EU AI 法」を、すべての社内 AI ツールが同じチェックリストを履行しなければならないかのように単純化すべきではありません。13
私たちはデータガバナンスを計画する際、問題を日常の操作に引き戻して考えます。売上データは誰が見られるのか?カスタマーサービスの記録には個人情報が含まれているか?管理者が照会結果をダウンロードできるか?外部 AI モデルを使用する際、どの列が送信されるのか?元ファイルはどれくらい保存するのか?もしある同僚が退職したり役割が変わったりした場合、権限はいつ取り消されるのか?データが修正された後、旧レポートとモデルの答えはどう更新されるのか?これらの問題は「モデルがどれだけ賢いか」ほど目を引くものではありませんが、企業が安心して AI をワークフローに組み込めるかどうかを決定します。
2025 年人工知能科技基金会によるデータガバナンスについての専門家インタビューでも、データガバナンスは戦略と応用シナリオから出発する必要があり、IT 部門だけに列の定義やツールの設置を任せるべきではないと指摘されています。ビジネス責任者は、データがどの意思決定を支えるべきかを最もよく理解しており、データチームはその定義を標準、品質チェック、データリネージに変換できます。両者は一緒に責任を負う必要があります。インタビューで提示されたガバナンス能力には、データが発見可能であること、認可されたアクセスが可能であること、デバッグ可能であること、実際のプロセスにデプロイ可能であることが含まれており、ちょうど企業がデータを「保存できる」状態から「よく使える」状態に推進する必要性に呼応しています。6
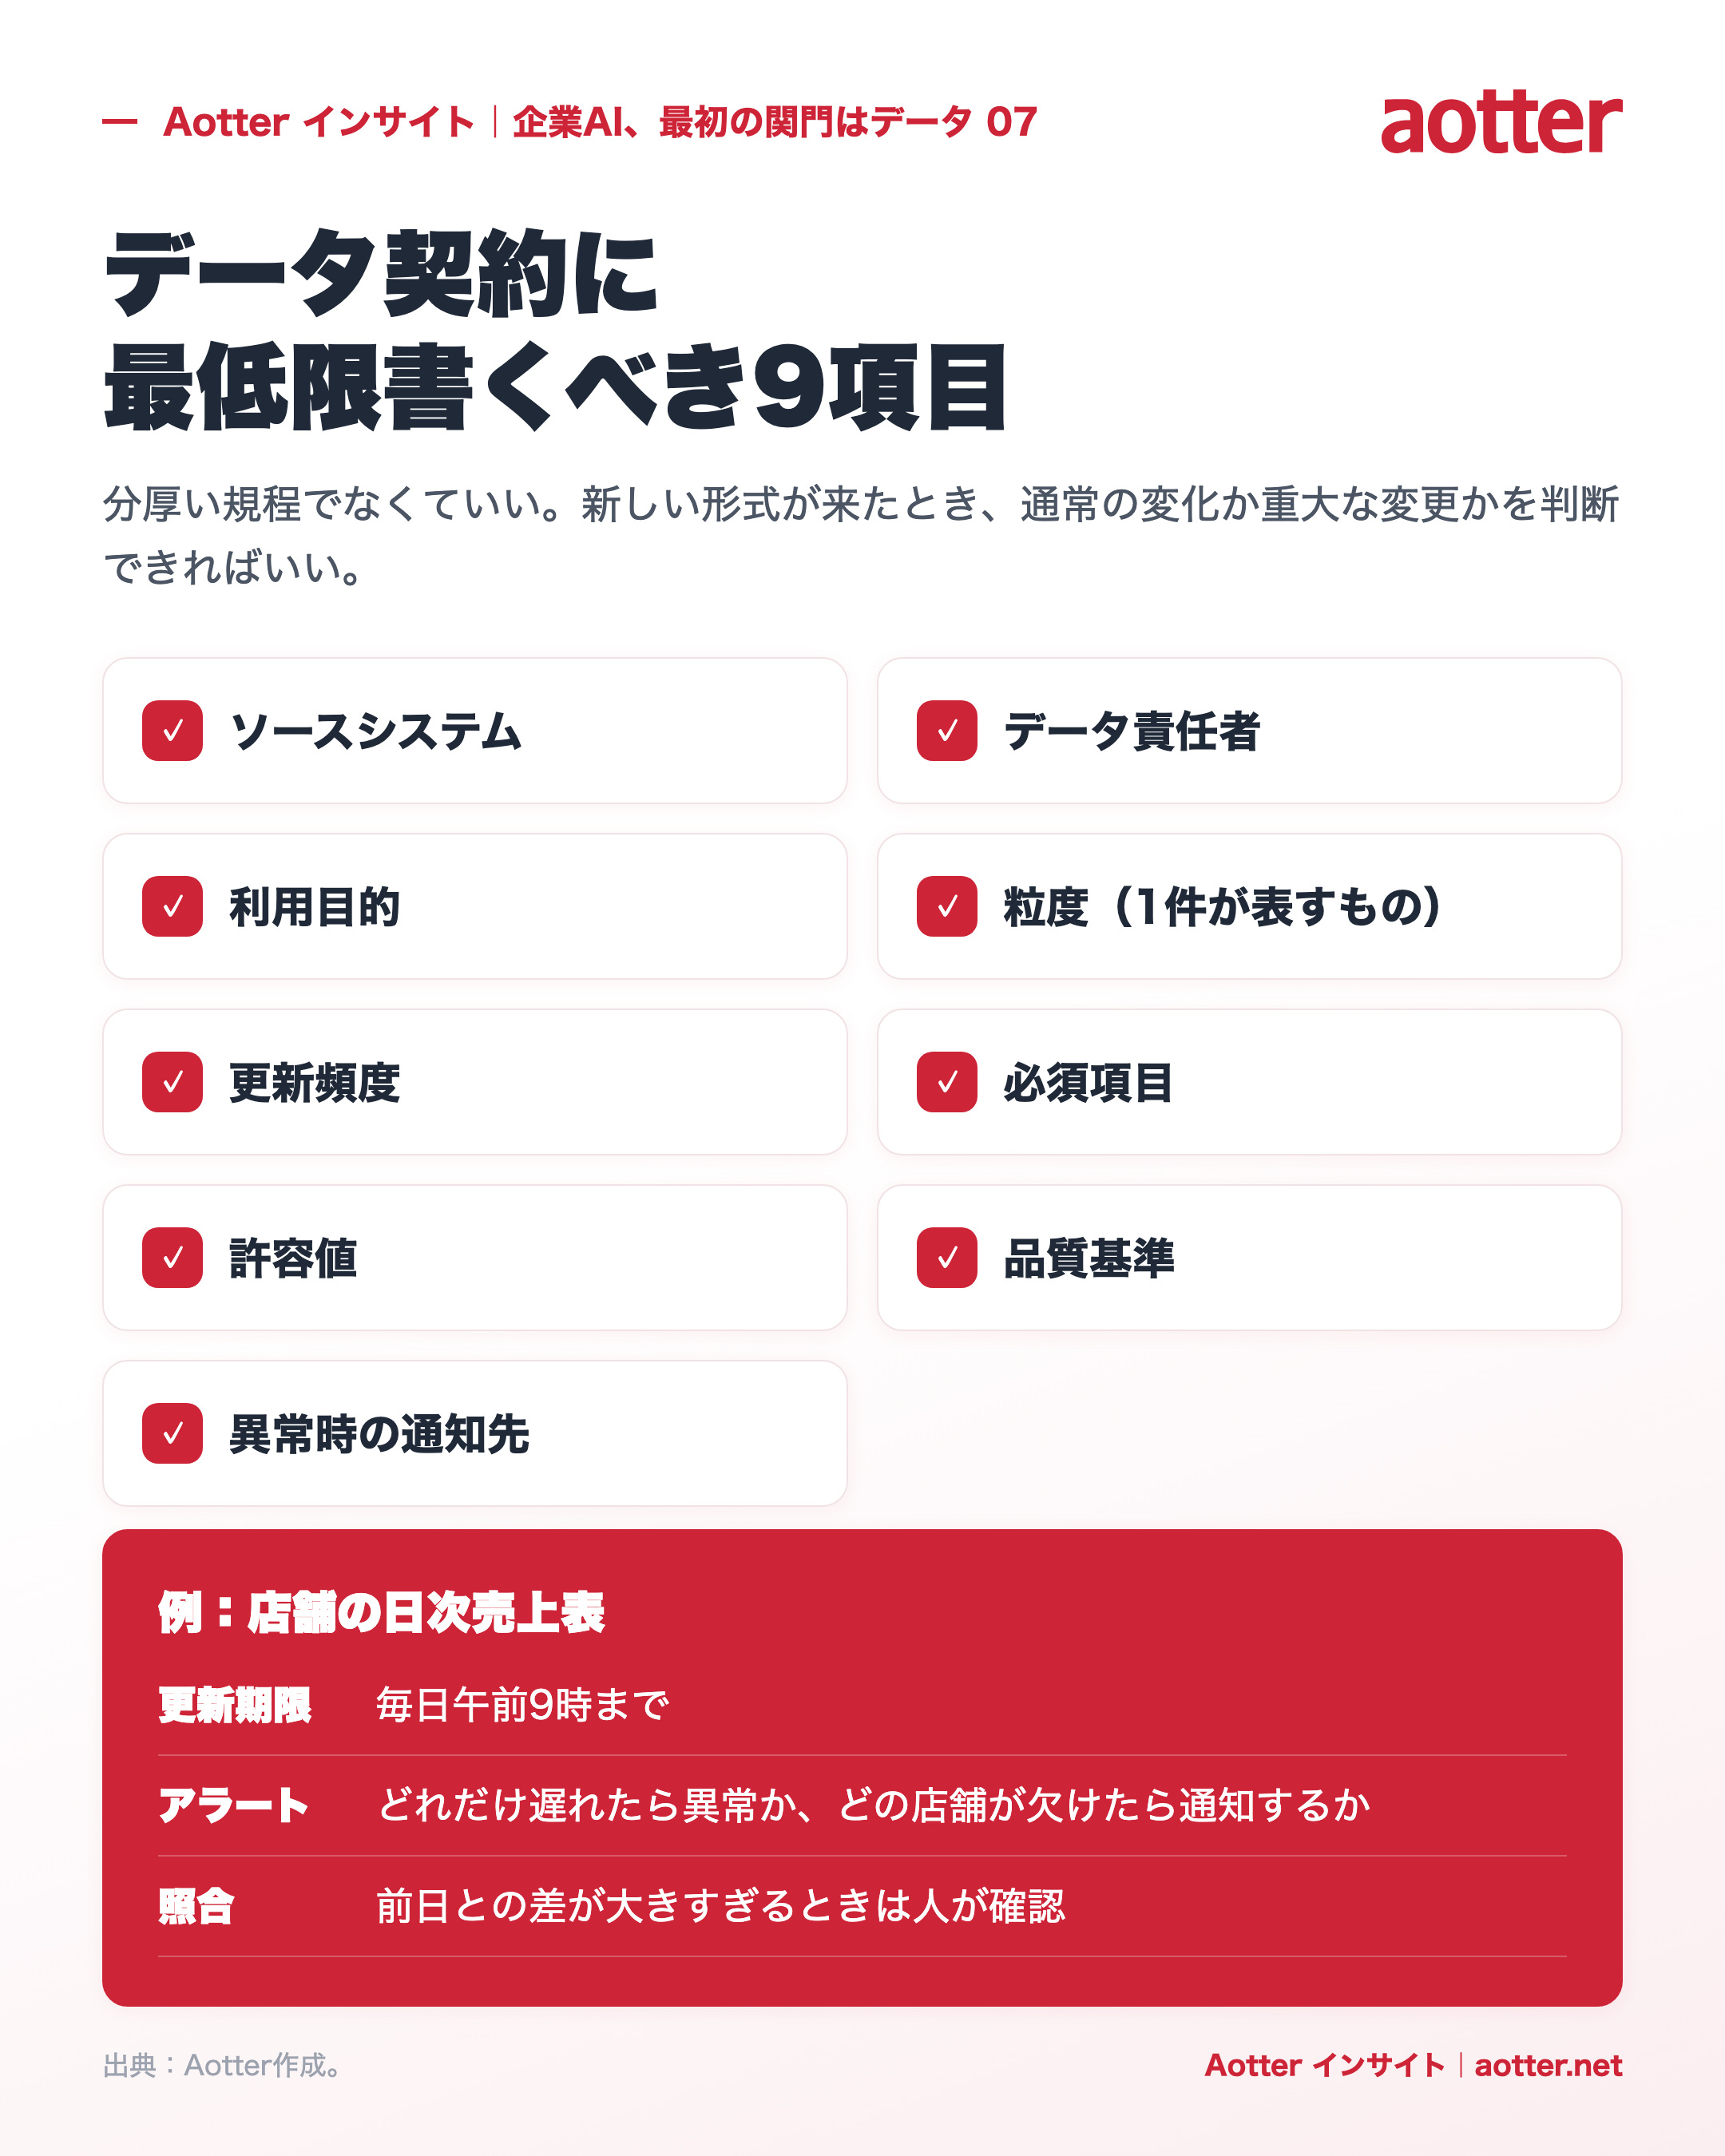
ガバナンスを実行可能な作業にするために、企業は重要なデータセットごとに簡潔なデータ契約を作成できます。契約は分厚い規範書として書く必要はありませんが、少なくともソースシステム、データ責任者、使用目的、各データが表す粒度、更新頻度、必須列、許容値、品質の閾値、データ異常時に誰に通知すべきかを列挙すべきです。新しい Excel 形式や列のバージョンが入ってきたとき、チームはこれが正常な進化なのか、それともインポートを一時停止すべき重大な変更なのかを判断できるようになります。
例えば、店舗ごとの日次売上表が毎日午前九時前に更新されると約束されているなら、企業はどれくらいの遅延を異常とみなすか、どの店舗が欠けていたら先にアラートを出すべきか、金額が前日とどれくらい差があったら照合が必要かを定義すべきです。商品在庫については、マイナス在庫、マッチしない商品コード、不合理な単日変動などのチェックを設定できます。これらの閾値は、すべての特殊なケースを一律にエラーとして扱うためのものではなく、責任者がどの差異を自動的に受け入れられるか、どれを必ず先に確認すべきかを知るためのものであり、データ品質が月末になって初めて誰かに発見されるという事態を避けるためのものです。
権限も任務に応じて分解すべきであり、単に「管理者」と「一般ユーザー」に分けるだけではいけません。財務責任者は会社全体の集計売上を見る必要があるかもしれませんが、店長は自分の店舗だけを見ればよく、分析担当者は匿名化された顧客セグメントデータを使用できるものの、電話番号や住所を取得する必要はないかもしれません。ロールベースの権限がデータセット、列、または行のレベルまで細かく設定できれば、異なる職務が業務を完了するために必要な最小限のデータだけを取得できるようになります。機密性の高い列については、マスキング、仮名化、集計クエリも検討し、データ漏洩後の直接識別のリスクを下げることができます。
操作記録も同様に、有用に設計されるべきです。「誰かがシステムを使用した」ということだけを記録するのでは、問題を追跡するには不十分です。企業はさらに、どの元データが処理されたか、どのルールのバージョンが適用されたか、どの行が隔離されたか、誰が再実行を承認したか、最終的にどのレポートやクエリが影響を受けたかを知る必要があるかもしれません。AI が問答に参加する際には、クエリの内容、モデルのソース、返されたデータの範囲、ダウンロード行為がポリシーに従って保存されているかどうかも確認する必要があります。監査ログもまた機密情報を含む可能性があり、それがデータを保護するために使われるからといって、ログ自体の権限と保存期限を無視してはいけません。
最後に、企業はデータの保存、削除、修正を同じライフサイクルに組み込むべきです。個人情報が必要な保存期間を超えたとき、顧客が削除を要求したとき、あるいは上流のシステムが取引記録を修正したとき、元のレイヤー、クリーニング後のデータ、集計表、既にスケジュールされたレポートはどう同期処理すべきでしょうか?バックアップ内のデータはいつローテーションされるのか?履歴レポートは法律上必ず保存しなければならないのか?これらの問題は導入前に法務、情報セキュリティ、ビジネス責任者と確認しておくのが望ましいです。データウェアハウスはデータを統合できますが、ガバナンス制度は統合後のデータが依然として企業の規範に従って使用されることを保証するものです。
デプロイ方式、モデルの選択、導入上の提案
企業によってデータの保存とモデルサービスへの要件は異なります。パブリッククラウド環境のマネージドサービスを使用できる企業もあれば、企業のプライベートクラウド、VPC、社内のデータセンターに置かなければならない企業もあります。AotterClam AI の公式資料には、企業のプライベートクラウドやオンプレミスデプロイのオプションが記載されており、ロールと権限の設定、操作記録が可能であること、またローカル推論または外部 AI モデルへの接続など異なる方式が提供されていることが説明されています。5
「データが国境を越えない」あるいは「データが会社を出ない」という話をするとき、私たちはこの一文を具体的なデータ経路に分解して確認することをお勧めします。データベース自体はどこに置かれているのか?バックアップとログはどの地域に保存されているのか?モデルの推論はどこで実行されるのか?ユーザーが質問をするとき、システムはどの列、要約、またはクエリ結果をモデルに送信するのか?サポート担当者はデータにアクセスできるのか?サービスプロバイダーのサブプロセッサーには何があるのか?「私たちはオンプレミスに構築している」と答えるだけでは不十分です。なぜなら、一つの企業システムには通常、バックアップ、監視、アップデート、外部モデル、運用保守のチャンネルも含まれているからです。
同様に、BYOK(Bring Your Own Key)とは通常、企業が自前のモデルサービスの API キーを用意することを指します。BYOAI はよく企業が自社の AI モデルやサービスを選択または持ち込むことを表すために使われます。これらはモデルと費用管理の採用方式であり、データが自動的に保護されることを意味するわけではなく、個人版の ChatGPT や Claude のサブスクリプションに必ず企業向け API の権限が含まれているという意味でもありません。実際に接続できるかどうか、どう課金されるか、データがモデルの学習に使われるかどうか、ログがどれくらい保存されるかは、モデルプロバイダーのサービス条項と企業のデプロイ設定に応じてすべて確認すべきです。
MCP は AI ツールが標準化された方式でデータサービスに接続できるようにしますが、MCP 自体はプライバシー保護プロトコルではなく、データがどこまで公開されるべきかを自動的に決定するものでもありません。企業は照会可能なデータ範囲、列のマスキング、ロールベースの権限、クエリの記録、外部モデルの使用ポリシーを定義する必要があります。もしユーザーが商品在庫と売上トレンドだけを必要とするなら、システムは同じデータベースに顧客の電話番号や住所があるからといって、それらの列を一緒にモデルに露出させるべきではありません。
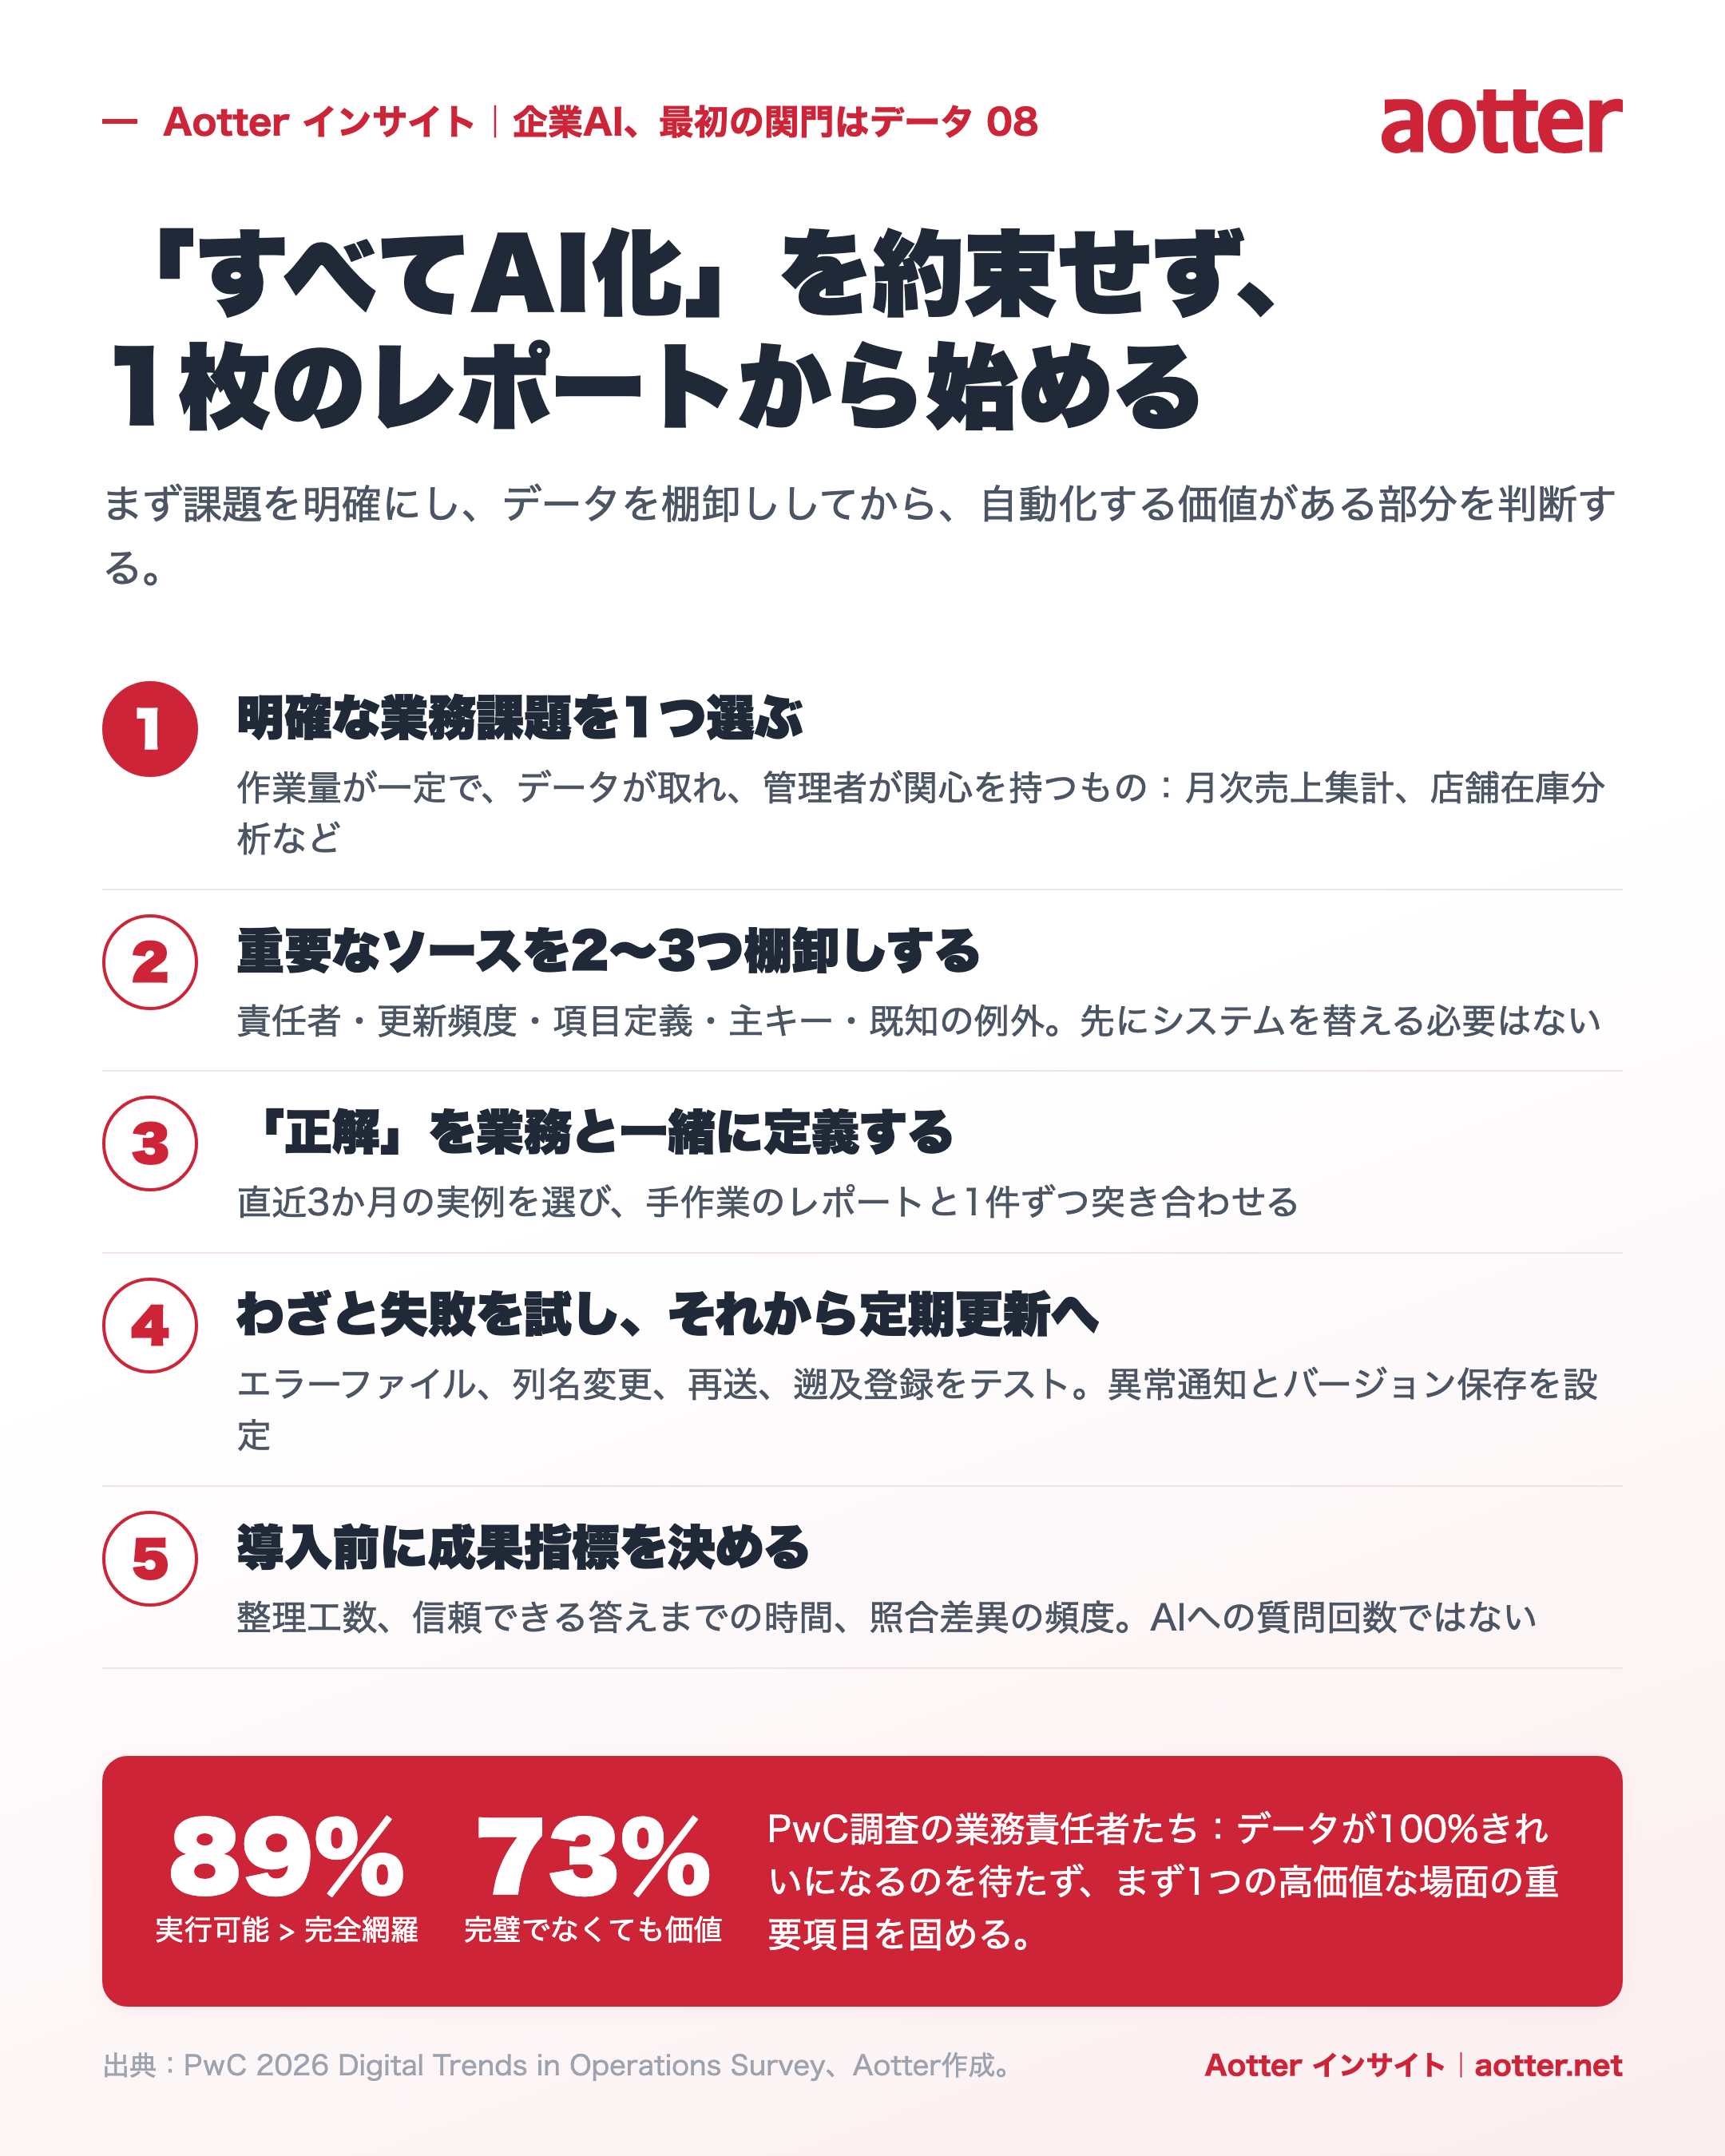
導入にあたっては、私たちは明確なビジネス上の質問から始めることをお勧めし、最初から「すべてのデータを AI 化する」と約束しないことをお勧めします。企業はまず、固定の作業量があり、データソースが取得可能で、管理者も気にかけている場面を一つ選ぶことができます。例えば毎月の売上集計、店舗ごとの在庫分析、サプライヤーの納期追跡、カスタマーサービスの問い合わせ分類などです。目標となる質問文を明確にすれば、どのデータを接続すべきか、どの列が重要か、検証方法は何かが分かります。
次に、最も重要な二〜三件のソース文書またはシステム出力の棚卸しを行います。各データの所有者、更新頻度、列の定義、保存規範、主キー、既知の例外を見つけ出す必要があります。このステップは、すべてのシステムを先に交換する必要はありません。まず既存のデータがスケジュールに従ってエクスポートできるかどうか、システムがデータを読み取る権限があるかどうか、データが企業指定の環境内で処理できるかどうかを確認します。もしデータが現状手動で送信するしかないなら、まず送信方法、ファイルの命名規則、受け取りルールを定めて、プロセスを安定させてから拡張を議論します。
さらに、ビジネス側と一緒に「正しい答え」の判断基準を定義します。目標が毎月の純売上であれば、少なくともキャンセル注文、返金、値引き、税額、出荷時間をどう計算するかを説明すべきです。目標が在庫回転であれば、期首在庫、期末在庫、輸送中の商品、欠品日数をどう処理するかを約束すべきです。直近三ヶ月の実際の事例を選び出し、既存の手作業レポートと一件ずつ比較して、差異がどのルールに起因するかを確認すべきであり、一枚のきれいなサンプルファイルだけでテストすべきではありません。
その後ようやく検証と拡張を手配します。まず一般的なファイルをテストし、意図的にエラーファイル、列名変更、空値の急増、再送信による重複ファイル、履歴データの補完、新しいコードの追加などのシナリオもテストすべきです。合格後にスケジュール更新を開始し、データ異常の通知、バージョン保存、手動での例外処理フローを設定します。二番目のソースが追加されたとき、企業はデータの関連が安定しているかどうかを観察し、三番目の部門を含めるかどうかを決定できます。
成果の測定も開始前から設定しておくべきです。同僚が毎月データ整理に費やす工数、質問から信頼できる答えを得るまでの時間、手動での作業のやり直しや照合の差異の頻度、管理者が意思決定前にレポートを待つ日数、または特定の在庫やカスタマーサービス指標の変化を記録できます。もし AI 問答の使用回数だけを計算するなら、「みんなが試用した」ということを「業務プロセスが改善された」ことと誤認しやすくなります。企業が導入前後の違いを明確に説明できるようになったとき、次の予算をデータ品質、プロセス自動化、あるいはより複雑なモデル応用のどこに投じるべきかが分かります。
PwC の 2026 年調査のもう一つの観察結果は、導入戦略に組み込む価値があります。回答した運営責任者のうち、89% が行動可能なデータの方が完全なデータを追求するよりも重要だと考えており、73% がデータが完璧でなくても価値を生み出せると考えています。これはデータのエラーを無視してよいという意味ではなく、企業がすべてのデータが「百パーセントクリーン」になるまで待つ必要はないということです。より現実的な方法は、まず一つの高価値な場面に対して重要な列の品質を向上させつつ、残りのデータも継続的に改善し、明確な検証とリスクの等級分けで最低限のラインを守ることです。2
AotterClam AI の位置づけ:まずデータを使えるようにし、それから使いたい AI を選ぶ
AotterClam AI の出発点は、企業が必ずしも短時間ですべての ERP を再構築できるわけではなく、データ活用を始める前にまず別の不慣れなシステムにデータを移行する必要もない、ということです。現在の私たちのプロダクト設計に基づくと、AI が Excel、CSV などのソースの理解を支援し、検証可能な整理定義を生成します。データはさらに固定ルールに従って検証、整理、倉庫への取り込みが行われ、その後は企業が使用権限管理、監査記録、BI ダッシュボード、AI 問答などの機能を利用します。デプロイとモデルのオプションは、企業のクラウド、VPC、またはオンプレミスの要件に応じて議論します。5
この方式と AI-ERP との違いは、「どちらが必ず良い」という単純な話に還元すべきではありません。AI-ERP は、企業がちょうど中核的な運営システムを刷新する必要があり、プロセスとデータ標準を一緒に再設計したいという状況に適しています。しかし、もし旧 ERP が依然として大量の日常業務を支えているなら、システム全体の交換にはデータ移行、プロセスの再編、人員トレーニング、外部システムとの連携、ダウンタイムのリスクが伴う可能性があります。AotterClam AI のようなデータガバナンスプラットフォームは、異なるソースが既に吐き出しているデータをまず処理でき、企業が中核システムを維持しながら部門横断的な分析能力を増強できるようにします。これは一部の移行コストを下げる一つの道であり、すべての企業が永遠に ERP を交換すべきでないという意味ではありません。
実は Aotter 自身も、つい最近のある従来型企業でのインタビューの過程で、ERP を直接再構築することが、既に旧システムに深く依存しているプロセス(人とシステムの協働であり、プロセスが社員に紐づいているため)に影響を及ぼす可能性があることに気づき、既存のレポートを利用してデータウェアハウスを構築する代替案の評価を始めました。この事例が示しているのは、「まずシステムが出力するデータを統合する」ことの価値です。もし企業の旧システムが既にメンテナンスを停止していたり、重大な情報セキュリティリスクが存在していたり、既に中核業務をサポートできなくなっていたりする場合は、再構築が依然として正しい選択である可能性もあります。本当に比較すべきなのは、全体的な変革コスト、運営リスク、将来のメンテナンス能力、期待される効果であり、プロダクト名に AI が入っているかどうかを比較することではありません。9
Aotter と福茂デジタルインテリジェンステクノロジー(福茂數位智能科技)は 2026 年に協業を発表しました。内容には企業向け AI データガバナンスのプロダクトとサービスの共同開発が含まれ、従来産業のデジタルトランスフォーメーションの経験を他の企業に提供できるソリューションに転化することも目指しています。14 私たちの考え方はとてもシンプルです。企業は AI のトレンドを追うためにすべてのデータをモデルに送る必要はなく、まず一つのチャットインターフェースですべての問題を包装する必要もありません。より重要なのは、まずデータを理解可能で、追跡可能で、更新可能な組織資産として管理し、明確な権限と用途を確立し、それから本当の業務ニーズに応じてモデルを選び、ツールを接続し、プロセスを変えることです。モデルは変わり、API は変わり、価格は変わりますが、企業が自社のプロダクト、顧客、注文、運営方法についての理解は、企業自身が管理できるデータ基盤の中に留めておくべきです。
現在 AotterClam AI は製造業、従来産業、鼎新 ERP、従来型 CRM、CDP 管理プラットフォームなど類似のものを使用している企業において、既に非常に迅速な導入事例を持っています。おそらく私たちとお話しいただければ、実際には大掛かりに土を掘り返すような作業やシステムの再構築をしなくても、便利に後発から追い上げられることに気づくでしょう。類似のニーズをお持ちの方は、ぜひフォームにご記入の上、私たちとお話しください。導入は大きな AI ビジョンを書き出すことから始める必要はありません。毎月手作業で整理しなければならない一枚のレポート、いつも答えが得られない一つの質問、あるいは何度も繰り返す照合プロセスから始めることができます。まず問題を明確にし、データの棚卸しをしっかり行い、それから一緒にどの部分が自動化する価値があるかを判断することが、先にたくさんのツールを買い揃えるよりも本当の変革に近づく道です。
最後に改めて自己紹介をさせてください。私たちは Aotter、AotterGirls のあの Aotter です。皆さんは最初私たちのコンテンツブランドをご存知だったかもしれませんが、Aotter はずっとデータとテクノロジーのプロダクトも作り続けてきました。アプリケーションツール、コンテンツと広告テクノロジーから、ファーストパーティデータ、データガバナンス、企業 AI へと進んできました。十数年来、私たちが関心を持ち続けてきたのは、どうすれば知識、コンテンツ、データをより速く使用可能な価値に変えられるかということです。今、この経験を AotterClam AI に活かし、企業がデータエンジニアリングのチーム全体を最初から持たなくても、段階的にデータを自分たちの能力に整理できるようにしたいと考えています。
AI は熱を帯びていますが、データはそのブームに単に乗っかるだけではいけません。データには定義する人、責任を負う人が必要であり、ルールが変わったときに再実行、検証、追跡できる必要もあります。企業がこうした一見目新しくない基礎的な作業に取り組む意思を持ったとき、AI は初めて一度限りの答えから、長期的に蓄積できる業務能力へと変わる機会を得るのです。
原作:Dr. Porkchop (Peng-han Su)(Aotter 共同創業者兼副 CEO)|改訂:Konois (Lun Hsieh)(Aotter 共同創業者兼 CEO)
参考資料
- Salesforce Marketing Statistics: First-Party Data and Data Unification
- PwC 2026 Digital Trends in Operations Survey
- EMARKETER: 2025 Trend, B2B Firms Are Laser-Focused on First-Party Data
- 2025 製造業 AI 普及度調査報告
- AotterClam AI 公式プロダクト紹介
- 人工智慧科技基金會:好數據才能讓 AI 落地,數據治理 1234 原則
- McKinsey: The State of AI in 2026
- McKinsey: The State of AI, How Organizations Are Rewiring to Capture Value
- 數位時代:不只是少女!電獺打造 AotterClam AI,憑兩大核心肌群搶攻 B2B 企業市場
- Aotter 公式会社紹介
- AotterTrek 公式紹介:ファーストパーティデータ研究開発の沿革
- 數位發展部:立法院三讀通過人工智慧基本法
- European Commission: AI Act Regulatory Framework
- 電獺:福茂數位智能科技與電獺合作公告
 AIアドバイザリー · Powered by MCP
もっと深く知りたい?「AOTTERSMAN」をあなたのAIアドバイザーに
この記事の詳細な推論と実践チェックリストは、AOTTERSMANナレッジベースに収録されています。MCPを導入すれば、お使いのAIアシスタント(Claude / Cursor / Gemini…)がAOTTERSMANの思考フレームワークを直接活用——常時オンラインのAIアドバイザーがもう一人増えるイメージです。
散在するデータを、一貫した答えに
ERP、Excel、NASに散らばるデータを、AIが安全に活用できる一貫したデータレイヤーに整えます。